Mistral发布万亿参数开源模型Le Chonk:聚焦企业可部署、主权可控的多模态基础模型
Mistral推出参数量达一万亿(490亿活跃)的开源权重模型ML4(代号Le Chonk),支持多模态输入与文本输出,专攻编程、网络安全、金融、工业视觉定位等场景,计划10月27日开放权重,强调零数据留存与主权基础设施部署能力。
Mistral 正在推出 Mistral Large 4的公开预览版,这是一款参数量达一万亿的多模态模型,代号为 “Le Chonk” 。这家巴黎人工智能公司表示,该模型将使其重新回归全球开源权重(open-weight)前沿——尤其聚焦于编程、网络安全、金融、制造业及视觉定位(visual grounding)领域。
该模型缩写为 ML4,拥有 490 亿活跃参数,是在 Mistral 自有的欧洲数据中心内,使用约 4000 块英伟达 Grace Blackwell GPU 从零开始训练而成,训练耗时约两个月。
Mistral 表示,该模型已在超过 160 种语言上完成训练,涵盖欧盟所有官方语言。
该公司计划通过 Mistral 的 API 提供该模型,并在为期约三周的开发者、网络安全负责人及政府主管部门测试期结束后,于 10 月 27 日发布模型权重。
模型权重将依据 Mistral 定制许可证发布;VentureBeat 审阅的材料中未提供 API 定价信息。
这种分阶段发布方式,是 Mistral 定位此次发布的重中之重。ML4 并非又一款通用型模型:该公司将其定位为企业和政府最终可自行部署与定制的基础模型,包括可在主权基础设施上运行,并支持零数据留存(zero-data-retention)选项。Mistral 表示,预览期也将为其争取时间,持续开展强化学习并优化最终检查点(checkpoint),待权重正式上线。
Mistral 联合创始人兼首席科学家纪尧姆·兰普尔(Guillaume Lample)在提供给 VentureBeat 的材料中表示:“ML4 处于开源权重模型的最前沿。”
兰普尔表示,Mistral 预计其能力将在强化学习完成后进一步提升,且随着训练算力扩展而增强。Mistral 表示,兰普尔已将其科研团队规模从三位研究员扩大至约 300 人。
从‘Le Chaton Fat’梗图到真实的万亿参数模型
对于任何关注前沿人工智能模型日益离奇的网络文化的读者而言,ML4 听起来或许像是数月前便已开启的一个玩笑的笑点。
今年 6 月,一款名为 “Le Chaton Fat” 的虚构 Mistral 模型在 X(原 Twitter)和 Reddit 上走红,配以伪造的基准测试图表,以及针对一款据称体型庞大的法国模型所提出的愈发荒诞的规格说明——该模型被宣称将一举超越其美国与中国竞争对手。 《商业内幕》(Business Insider)报道称 该玩笑于 6 月传播开来,部分版本声称这款并不存在的模型参数量超过 30 万亿,另一些版本则宣传其具备“每秒 1000 次喵叫”之类的能力。Mistral 首席执行官阿瑟·门施(Arthur Mensch)最终也加入其中,在 X 上发文写道:“其实它是 le gros chaton(法语:大猫崽)。”
在这些网络恶搞(shitposting)背后,实则存在一种真实预期:即 Mistral 正在筹备某种规模远超以往的模型。到了 7 月, 《TechCrunch》报道称 业界正翘首期待一款即将发布的大型开源权重 Mistral 模型,并指出门施与 Mistral 投资人马克·安德森(Marc Andreessen)曾推波助澜,放大了‘Le Chaton Fat’的玩笑效应。
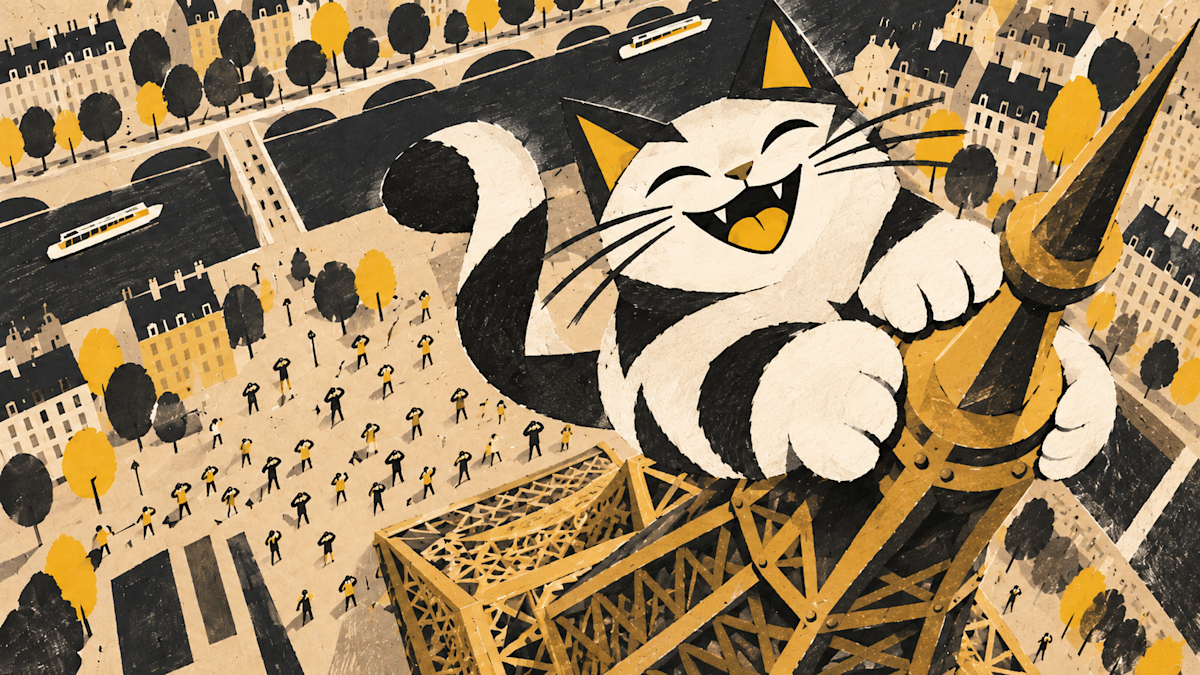
如今 Mistral 真正拥有了一个万亿参数模型——而且看起来该公司决定不浪费这个玩笑。在内部,ML4 使用的昵称为 “Le Chonk” ,这是对互联网俚语中特指体型异常庞大猫咪的又一戏仿。
当 VentureBeat 就 ML4 是否实质上正是‘Le Chaton Fat’梗图所预示的模型向兰普尔提问时,他表示 Mistral 很享受这一梗图,并暗示 ML4 可被视为该构想的初始版本,未来还将推出规模更大的模型。Mistral 高管表示,‘Le Chonk’这一名称刻意致敬了长期支持该公司打造巨型前沿模型的社区。
因此,这个玩笑意外地高度贴近现实:‘Le Chaton Fat’从未真实存在,但几个月后,Mistral 却发布了一款真正的一万亿参数开源权重旗舰模型,并赋予其一只‘胖猫’的代号。
一万亿参数,但仅 490 亿活跃
ML4 采用稀疏架构:尽管其总参数量达一万亿,但在推理过程中仅有 490 亿参数处于活跃状态。该设计延续了当前超大规模开源模型的普遍趋势,即不断提升模型总容量,同时每次仅激活网络中的一小部分。
Mistral 还强调,相较于最大型的前沿模型项目,该公司声称训练该系统所需硬件资源极少。4000 块 Blackwell GPU 在绝对数量上已属可观,但该公司认为,与美国大型实验室所拥有的资源相比,这一规模仍属适中。由于竞争对手并未以统一标准公开完整的训练计算量数据,精确的效率对比十分困难。作为参照, Mistral 表示,其此前发布的 Large 3 模型 ——一款参数量为 6750 亿的混合专家(mixture-of-experts)模型,含 410 亿活跃参数——系在 3000 块英伟达 H200 GPU 上训练而成。
兰普尔在 VentureBeat 的采访中确认,新模型可接收多模态输入,但仍仅输出文本。Mistral 将目标应用场景定位于软件工程、网络防御、金融分析、卫星与航拍影像、技术图纸及芯片设计。
网络安全是上述类别中战略意义最强的一项。Mistral 认为,企业无法完全依赖封闭式供应商,因其安全系统可能拒绝那些虽具双重用途但属正当防御需求的请求。该公司主张,开源权重模型可使安全团队对代码扫描、防御性测试及其他高吞吐量安全工作流实现更强控制力,而不必受制于供应商不断变动的内容审核政策。
基准测试结果表现强劲——但实际情况比 Mistral 图表所呈现的更为复杂
Mistral 提供了初步测试结果,显示 ML4 在长周期软件工程基准测试 DeepSWE v1.1 上得分为 62%。其图表中列出 Reflection AI 新推出的 Beam 模型得分为 44%,Qwen 3.8 Max 为 51%,DeepSeek V4 Pro 0813 为 57%,GLM-5.3 为 61%。
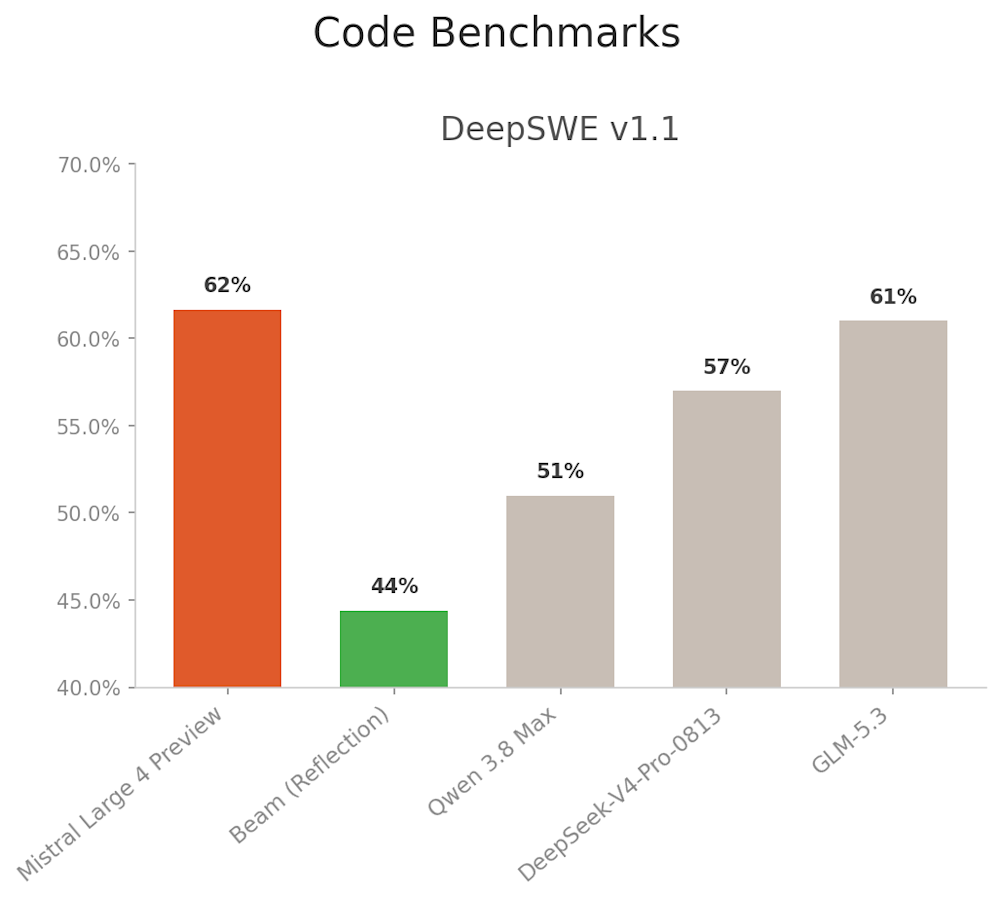
Mistral Large 4 DeepSWE v1.1 基准测试对比图表。图片来源:Mistral
这些竞品分数大体可追溯至公开信源,但基准测试的具体配置至关重要。
Reflection 自身发布的 Beam 模型公告 昨日报告称,在其对比测试设置下,Beam 得分为 44.4%,Qwen 3.8 Max 为 51%,GLM-5.3 为 61%。
人工智能分析机构(Artificial Analysis)另据报道 ,当 DeepSeek V4 Pro 0813 与 Codex 智能体框架(agent harness)配合使用时,在 DeepSWE 上取得 57% 的成绩。
但 实时 DeepSWE 排行榜 在为每个模型选择已发表的最佳配置时,情况则截然不同:目前它将 GLM-5.3定为约69%,Kimi K3也约为69%,而GPT-6 Astra、Gemini 3.8 Flash和Claude Opus 5则约为74%。
换言之,ML4的62%预览结果看起来具备竞争力,尤其相对于Beam等西方开源权重模型,但它并未 未 在所有现有模型与智能体配置中确立绝对的编程领先优势。
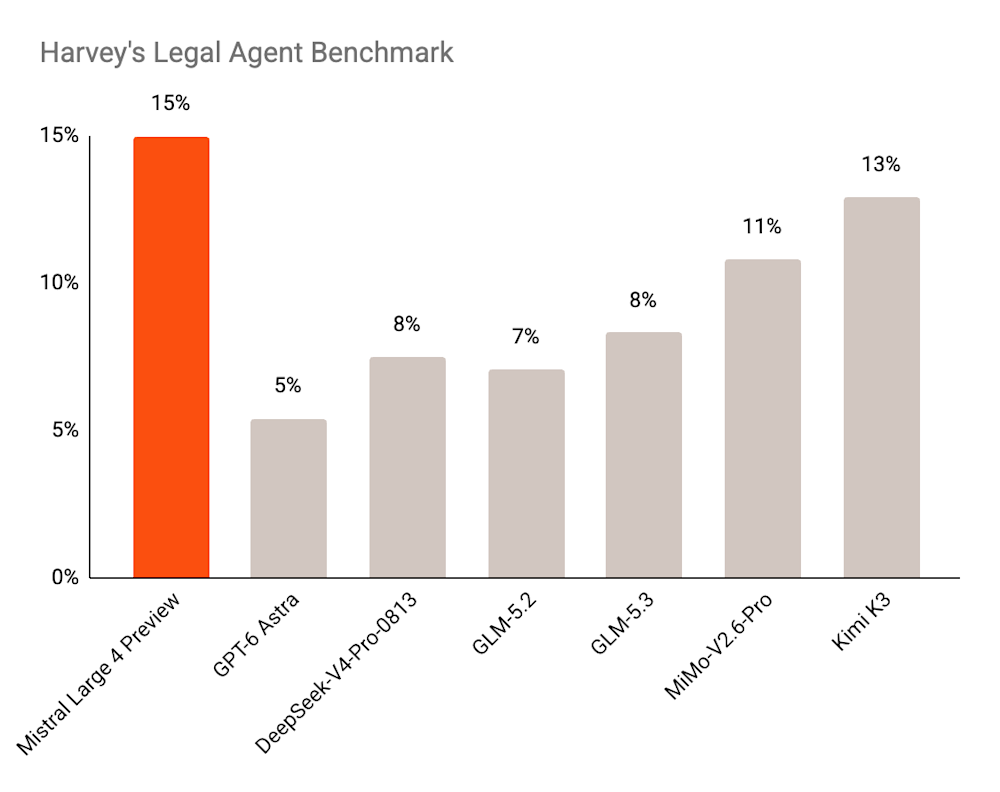
Mistral Large 4 Harvey法律智能体基准测试对比图表。图片来源:Mistral
法律基准测试提供了更清晰的外部交叉验证。Mistral的图表显示ML4在Harvey法律智能体基准测试中任务通过率为 15%。 Vals.ai的公开排行榜 当前报告Kimi K3为12.92%,MiMo V2.6 Pro为10.83%,GLM-5.3为8.33%,与Mistral对比图表中相关四舍五入后的竞品数据一致。若ML4的15%是在相同方法论下得出,则该模型将领先于上述开源权重竞品;不过Vals当前有若干专有模型得分高于这一水平。
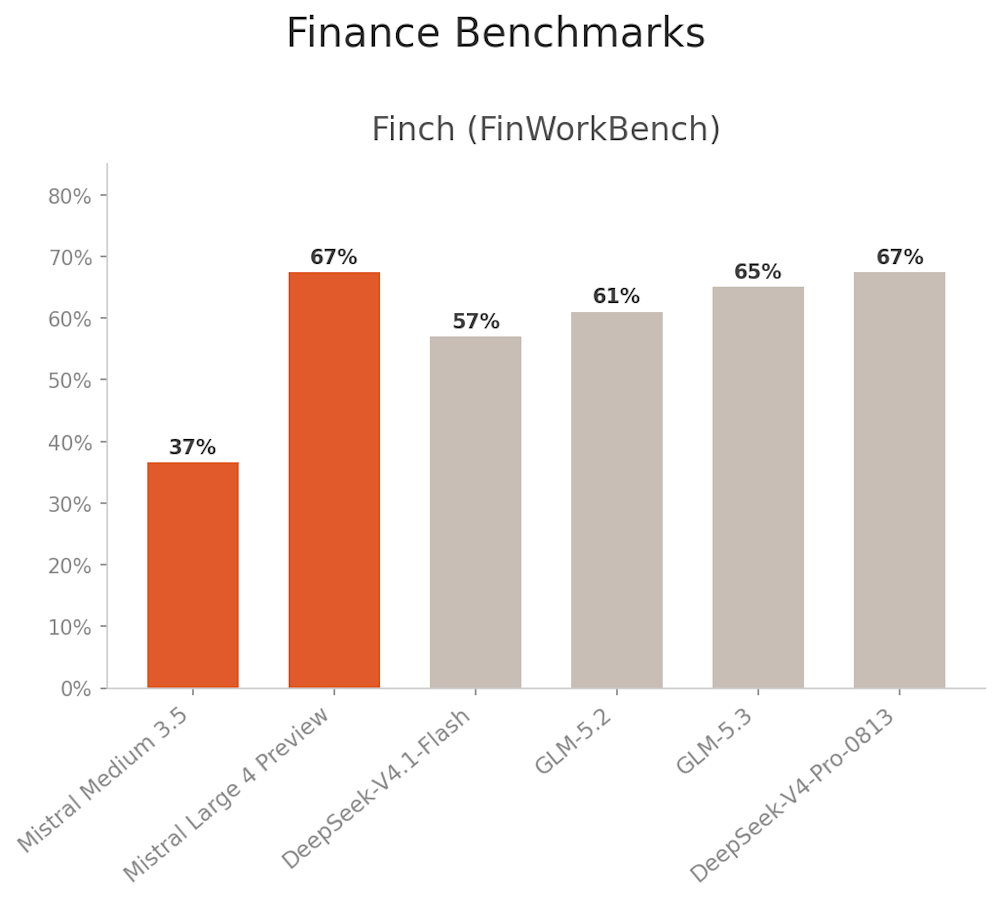
Mistral Large 4 FinWorkBench基准测试对比图表。图片来源:Mistral
Mistral还报告ML4在Finch上得分为 67%,这是一个面向企业财务与会计工作流的基准测试,在其提供的图表中与DeepSeek V4 Pro 0813并列,并领先于GLM-5.3的65%。 Finch本身是一个已获ACL 2026会议接受的公开基准测试;其384项任务涵盖基于混乱的企业级数据所构建的长时间运行的电子表格、文档、搜索、建模及报表工作流。但VentureBeat未能独立查找到Mistral图表中所示最新模型分数的已发表Finch测试结果。
同样的注意事项亦适用于Mistral关于视觉定位能力的主张。其材料显示ML4在Dense200上得分为42%,在DIOR-RSVG上得分为73%,领先于其对比图表中大多数通用模型。 Dense200和DIOR-RSVG是已发布的视觉定位基准测试,但Mistral幻灯片中列出的确切GPT-6 Astra、Kimi K3及DeepSeek测试结果并未出现在VentureBeat所审阅的公开基准测试资料来源中。
这一区别至关重要,因为Mistral最重大的战略主张并非ML4在整体上超越所有闭源模型,而是其作为中国以外开发的最强开源权重模型,且可与中国最强的开源系统相抗衡。截至发稿时,ML4尚未出现在 Artificial Analysis的公开评测 或 DeepSWE排行榜中,因此Mistral的排名主张仍属暂定,须待外部人员对最终模型及已发布权重进行测试后方能确认。
Mistral更大的押注:开源权重加主权企业技术栈
ML4的发布恰逢Mistral的关键时刻。 该公司成立于2023年 ,创始人为前DeepMind研究员Arthur Mensch以及前Meta研究员Guillaume Lample和Timothée Lacroix,迅速成长为欧洲最具影响力的挑战者之一,直面美国与中国基础模型实验室的竞争。
其 首个Mistral 7B模型 于2023年9月发布,同年晚些时候又推出稀疏型Mixtral 8x7B,由此确立了公司围绕高效、公开可用模型权重的战略。
此后,该公司业务已大幅拓展至模型权重之外。其技术栈现包括面向开发者与企业的各类产品、定制化服务、推理基础设施以及Mistral Compute——这属于一项更广泛的努力,旨在向企业销售的不仅是模型访问权限,更是对其基础设施、部署及工程环节的控制权。 Mistral的产品与新闻档案 记录了这一扩张历程。
今年9月, Mistral宣布完成30亿欧元D轮融资 ,投后估值超过 210亿欧元,该公司称此轮融资为欧洲科技公司迄今完成的最大规模股权融资。 路透社报道称 其估值约为240亿美元。Mistral表示,目前其已支持逾125家全球企业,包括空中客车(Airbus)、阿斯麦(ASML)和汇丰银行(HSBC)。
这一全栈式战略亦解释了为何Mistral乐于发布强大权重,而非将其旗舰模型完全置于API之后。Lample向VentureBeat表示,客户日益需要的远不止模型访问权限:部署、基础设施、定制化及针对日益复杂AI工作流的工程支持,均已构成业务的重要组成部分。Mistral实质上是在押注模型权重将日趋商品化,而更高价值的企业业务重心则转向围绕这些权重所构建的系统。
对企业而言,实际问题是:当独立评测者得以测试ML4最终检查点时,其表现能否经受住检验;以及Mistral能否将其主权主张转化为在成本、控制力与定制化方面的可衡量优势。该公司给自己留出三周时间,待权重公开发布。10月27日之后,“Le Chonk”这一绰号的重要性将让位于开发者在其自有硬件上所能复现的实际效果。
JOTO 企业落地观察
- 该模型明确支持在客户自有主权基础设施上部署并启用零数据留存选项,为企业规避封闭API的数据合规风险提供了可行路径,尤其利好受GDPR或行业数据本地化要求约束的欧洲及亚太金融机构与国防供应商。
- ML4虽仅输出文本,但已适配卫星影像、技术图纸、芯片设计等视觉定位任务,其Dense200和DIOR-RSVG基准表现暗示其可作为智能体工程中的高精度多模态感知前端,嵌入RAG+Agent工作流以增强工业文档理解与缺陷识别能力。
- Mistral将网络安全列为战略优先场景,主张开源权重使安全团队能自主控制代码扫描与防御性测试流程,避免受制于闭源模型的内容策略波动——这对需高频执行红蓝对抗、漏洞挖掘与合规审计的企业安全部门具有直接落地价值。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们