Qwen3.8-Max发布:2.4万亿参数MoE多模态模型挑战智能体计算前沿
阿里巴巴Qwen团队发布Qwen3.8-Max,2.4万亿参数混合专家多模态大模型,在OSWorld-Verified等智能体计算基准中超越GPT-5.6 Sol Max与Fable 5,并承诺下周开源权重;其长周期任务执行能力、计算机使用能力和经济性定价引发企业级智能体部署新讨论。
中国电商与云计算巨头阿里巴巴旗下著名的AI研究团队Qwen昨晚 发布了Qwen3.8-Max,这是一款新的旗舰级2.4万亿参数混合专家(MoE)多模态大语言模型(LLM),旨在切入前沿AI市场中竞争最激烈的细分领域之一:自主软件工程与长周期企业级任务。
如果该公司公布的基准测试结果能在更广泛的独立测试中得到验证,那么Qwen3.8-Max不仅将与当前领先的专有模型展开竞争——它还在部分关键的智能体计算(agentic computing)基准测试中超越了其中若干模型。
尤为突出的是,Qwen报告称Qwen3.8-Max在衡量智能体使用计算机操作系统及其上应用程序能力的 OSWorld-Verified 基准测试中得分86.1,高于GPT-5.6 Sol Max(83.2)和Fable 5(85.0)。
该模型还在 PaperBench基准测试中取得迄今报告的最高分;该基准由OpenAI制定,用于衡量智能体能否根据实验数据重建科研论文,并在软件工程、科研复现、多模态推理及视觉网页开发等基准测试中处于领先或高度竞争力水平。
此次发布还可能标志着阿里巴巴一项潜在的重大战略转向:该公司表示,Qwen3.8-Max的开源权重将于下周与Qwen3.8-27B一同发布。
若该开源权重以宽松许可协议发布,这将是Max级Qwen模型首次可供用户自托管部署——此举可能显著重塑企业级采用格局。
然而,一个重要的注意事项依然存在:阿里巴巴尚未披露具体的许可条款,因此尚不能排除其采用更具限制性的定制许可协议的可能性,正如我们近期所见的 中国竞争对手月之暗面(Moonshot)为其开源前沿模型Kimi K3所采用的许可方式,而非Apache 2.0等广泛认可的宽松许可协议。
‘前沿’的另一种定义
过去一年间,基础模型的竞争格局正日益专业化。
OpenAI主要将其GPT系列聚焦于通用推理、多模态交互及企业生产力。
Anthropic的Claude系列则强调编程能力与可靠的长上下文推理能力。谷歌持续推动Gemini朝向多模态生产力与原生网页工作流方向发展。
月之暗面(Moonshot AI)的Kimi K3近期加入这一竞争,将前沿级性能与开源权重发布相结合。
Qwen3.8-Max试图将上述多项优势整合进单一模型,其目标明确指向企业自动化。
阿里巴巴并未强调对话智能,而是将该模型定位为一名可自主执行跨越数日(而非数分钟)项目的“自主同事”。
据该公司称,Qwen3.8-Max可自主完成持续时间超过10天的软件项目,复现涉及数千行代码的科研论文,执行迭代式芯片设计优化,并利用多模态反馈回路持续修订计划。
这些演示均由该公司自行制作,目前尚未被独立评估者广泛复现。尽管如此,它们揭示了一种日益明显的行业趋势:前沿模型正越来越多地围绕其完成整套工作流的能力展开竞争,而非仅针对单个提示词作答的能力。
基准测试日益奖励自主执行能力
随Qwen3.8-Max一同发布的基准测试套件正反映了这一转变。
这些基准测试不再仅聚焦于传统推理考试或编程谜题,其中许多重点评估长周期执行能力。
在评估计算机使用型智能体与桌面环境交互能力的OSWorld-Verified基准测试中,Qwen3.8-Max得分为86.1,高于GPT-5.6 Sol Max的83.2、Fable 5的85.0以及Gemini 3.1 Pro的76.2。
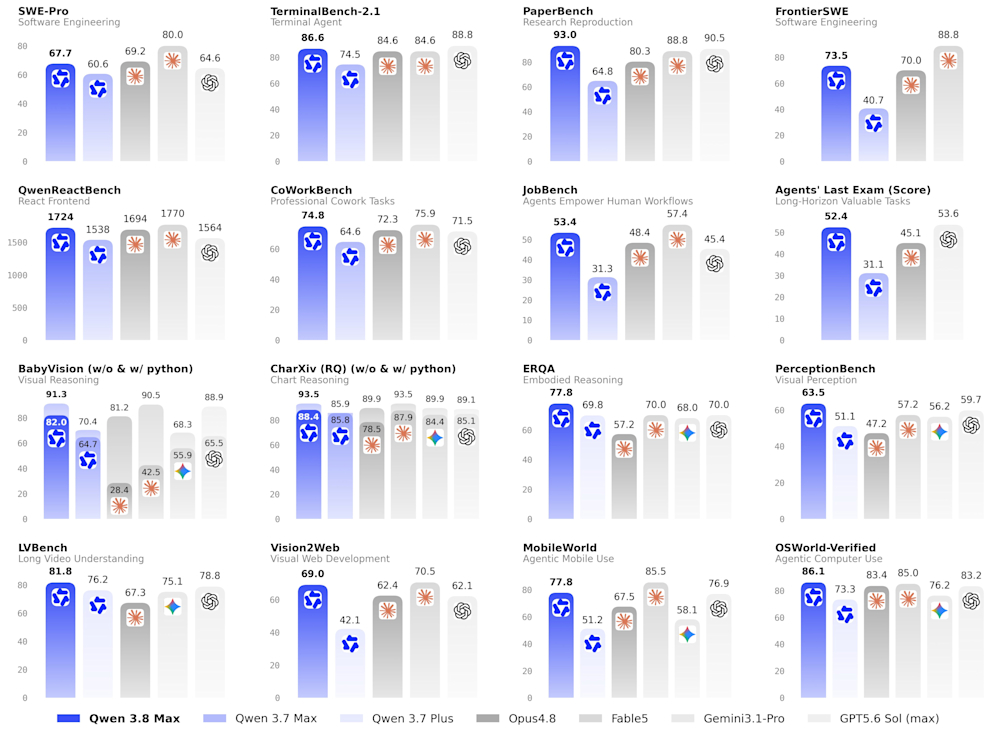
Qwen3.8-Max基准测试对比柱状图。图片来源:阿里巴巴Qwen
该模型亦在以下基准测试中领先:
PaperBench:93.0
TerminalBench 2.1:86.6
Vision2Web:69.0
LVBench:81.8
ERQA:77.8
在其他方面,该模型虽仍与专有领导者保持竞争力,但在若干类别中落后。
例如,在专业软件工程基准测试SWE-Pro中,OpenAI的模型获得迄今报告的最高分;而Opus 4.8则继续在某些软件工程评估及Agents' Last Exam中保持领先。
Qwen似乎并未在每一项基准测试中均占据主导地位,而是提供了当前可用模型中最均衡、覆盖面最广的综合性能表现之一。
这种均衡性对企业的采购决策而言,最终可能比单项基准测试的胜出更具意义。
如今,众多组织正越来越多地依据模型完成异构工作流的可靠性来评估其价值——包括编写代码、阅读文档、导航界面、生成报告、检查图像以及协调多个子任务——而非针对某项狭窄能力进行优化。
Qwen3.8-Max表现最强的领域
假设阿里巴巴公布的测试结果能在实际生产部署中得以复现,那么若干企业级工作负载将尤其适合Qwen3.8-Max。
1. 长周期软件工程
阿里巴巴的主要演示聚焦于持续时间超过十天的自主软件开发。
尽管企业应将这些演示视为供应商声明,直至其经独立复现验证,但它们契合了业界日益增长的兴趣:即构建可连续运行而非仅交互式响应的持久化编码智能体。
正在试验自主工程团队、CI/CD自动化、代码仓库维护、回归测试或功能实现的组织,若Qwen的智能体性能在实验室之外的实际环境中亦能保持一致,则可能特别青睐该模型。
2. 计算机使用型智能体
最具差异化优势的领域或许是计算机使用能力。
OSWorld 已迅速成为业内最受关注的基准测试之一,因为它衡量的是模型与操作系统交互的能力,而非仅生成文本。
能够可靠操作桌面软件的模型可自动化大量重复性业务流程,包括文档处理、企业软件集成、内部运营以及缺乏 API 支持的遗留工作流。
因此,若 OSWorld 基准测试表现能在实际生产环境中泛化,领先该基准测试便可能转化为真实的运营优势。
3. 研究自动化
Qwen 在 PaperBench 上的领先地位表明,其在科学计算、文献综述、实验复现和技术分析等科研任务中具备强劲潜力。
研究机构、制药公司及工业研发团队正日益将大语言模型(LLM)不仅用于摘要生成,还用于执行可复现的计算工作流。在这些环境中,能够在长时间会话中持续维持上下文的模型价值愈发凸显。
4. 多模态工业工作流
与早期主要分析上传图像的多模态系统不同,Qwen 将视觉能力描述为一种持续的反馈机制,并将其整合进规划与执行过程。
该架构在制造、物流、工程检测和设计评审等领域可能尤为有用,因为在这些场景中,视觉输入持续为运营决策提供信息,而非仅作为孤立的提示。
经济性因素可能同样重要
或许最大的竞争压力并非来自基准测试分数,而是来自 Qwen 通过其应用编程接口(API)在 QwenCloud (总部位于中国)所提供的定价:
Qwen3.8-Max 的发布价格为每百万输入/输出 token 2 美元/6 美元,属中端价位模型,但相较与其进行基准测试对比的美国顶级专有模型,其价格显著更低——不足 Claude Opus 5 输入加输出总价格的三分之一,亦不足 GPT-5.6 Sol Max 价格的四分之一。
模型 | 输入(美元/百万) | 输出(美元/百万) | 总计(美元/百万) | 来源 |
MiMo-V2.5 Flash | 0.10 美元 | 0.30 美元 | 0.40 美元 | |
deepseek-v4-flash | 0.14 美元 | 0.28 美元 | 0.42 美元 | |
deepseek-v4-pro | 0.435 美元 | 0.87 美元 | 1.305 美元 | |
GPT-5.6 Luna | 0.20 美元 | 1.20 美元 | 1.40 美元 | |
MiniMax-M3 | 0.30 美元 | 1.20 美元 | 1.50 美元 | |
LongCat-2.0 — 限时促销 | 0.30 美元 | 1.20 美元 | 1.50 美元 | |
Gemini 3.1 Flash-Lite | 0.25美元 | 1.50美元 | 1.75美元 | |
Qwen3.7-Plus | 0.40美元 | 1.60美元 | 2.00美元 | |
MiMo-V2.5 | 0.40美元 | 2.00美元 | 2.40美元 | |
Gemini 3.5 Flash-Lite | 0.30美元 | 2.50美元 | 2.80美元 | |
LongCat-2.0 — 标准版 | 0.75美元 | 2.95美元 | 3.70美元 | |
MiMo-V2.5 Pro(≤256K) | 1.00美元 | 3.00美元 | 4.00美元 | |
GLM-5.2 | 1.40美元 | 4.40美元 | 5.80美元 | |
Grok 4.5 | 2.00美元 | 6.00美元 | 8.00美元 | |
MiMo-V2.5 Pro(>256K) | 2.00美元 | 6.00美元 | 8.00美元 | |
Qwen3.8-Max | 2.00美元 | 6.00美元 | 8.00美元 | |
Gemini 3.6 Flash | 1.50美元 | 7.50美元 | 9.00美元 | |
Qwen3.7-Max | 2.50美元 | 7.50美元 | 10.00美元 | |
Gemini 3.5 Flash | 1.50美元 | 9.00美元 | 10.50美元 | |
Gemini 3.1 Pro Preview(≤200K) | 2.00美元 | 12.00美元 | 14.00美元 | |
GPT-5.6 Terra | 2.00美元 | 12.00美元 | 14.00美元 | |
GPT-5.4 | 2.50美元 | 15.00美元 | 17.50美元 | |
Kimi K3 | 3.00美元 | 15.00美元 | 18.00美元 | |
Gemini 3.1 Pro Preview(>200K) | 4.00美元 | 18.00美元 | 22.00美元 | |
Claude Opus 5 | 5.00美元 | 25.00美元 | 30.00美元 | |
GPT-5.5 | 5.00美元 | 30.00美元 | 35.00美元 | |
GPT-5.5 Instant(chat-latest) | 5.00美元 | 30.00美元 | 35.00美元 | |
Sakana Fugu Ultra(≤272K) | 5.00美元 | 30.00美元 | 35.00美元 | |
GPT-5.6 Sol — 标准模式 | 5.00美元 | 30.00美元 | 35.00美元 | |
Claude Fable 5 / Claude Mythos 5 | 10.00美元 | 50.00美元 | 60.00美元 | |
GPT-5.6 Sol — 快速模式 | 10.00美元 | 60.00美元 | 70.00美元 |
推理成本降低正变得日益重要,因为智能体系统消耗的token数量远超传统聊天机器人——这一现实很可能影响了OpenAI上周晚些时候的决策,即 将其GPT-5.6中端及入门级模型系列(Terra和Luna)的API价格分别下调20%和80%。 (Terra和Luna)分别下调20%和80%。
事实上,正如这些系统的运行者所证实的那样,持续数小时的自主工作流、迭代式规划以及持续的自我修正,可能在单个任务中生成数百万个token。
对于同时部署数百或数千个智能体的企业而言,推理成本往往成为最大的运营开支之一。因此,每个token价格的微小降幅会迅速产生复利效应。
与美国前沿模型的对比
尽管存在 headline 级别的基准测试对比,Qwen3.8-Max 并不一定应被视为对领先美国模型的全面替代品。
相反,其优势表明了不同的部署策略。
OpenAI 的 GPT 系列继续作为一款能力广泛的企业级推理平台表现出色,具备成熟的工具链、生态系统集成以及广泛的商业部署。已深度投入微软生态或 OpenAI 企业服务的组织,即便 Qwen 在部分智能体基准测试中领先,仍可能继续重视这些运营优势。
Anthropic 的 Claude Opus 仍被广泛视为最强的编程助手之一,尤其适用于严谨的软件工程和长上下文推理。一些企业可能仍倾向于在需要人工参与的开发场景中使用 Claude,此时可靠性与可预测行为的重要性超过纯粹的自主性。
Google Gemini 凭借与 Workspace 的深度集成、多模态能力以及 Google Cloud 服务持续实现差异化,使其对已采用 Google 企业技术栈的组织颇具吸引力。
Qwen 最具吸引力之处在于,它面向优先考虑自主执行、更长规划周期以及有利推理经济性的企业,且不以牺牲前沿级性能为代价。
开源权重问题仍未解答
围绕 Qwen3.8-Max 的最大未知因素几乎与基准测试无关。
阿里巴巴表示开源权重将于下周发布。然而,该公告及所提供的文档均未明确说明将用于规范这些权重的许可证类型。
这一区别可能至关重要。
若采用 Apache 2.0 等宽松型许可证,则将显著扩大企业采用范围,允许组织在限制极少的情况下自行托管、微调并将该模型集成至专有产品中。
若采用定制许可证——类似于近期若干前沿模型发布的做法——则可能对商业部署、再分发、使用领域或模型修改施加限制。此类限制将削弱该模型对寻求长期基础设施投资企业的吸引力,无论其技术性能如何。
月之暗面(Moonshot AI)近期发布的Kimi K3凸显了这一区别的重要性。尽管Kimi K3将其模型权重向所有人公开,但其 许可条款中包含特定条款 包括一项披露要求,以及针对将该模型作为“模型即服务”(Model as a Service)提供者的商业许可要求。
在阿里巴巴发布Qwen3.8-Max的许可证之前,考虑自托管的组织应将此次开源权重公告视为前景可期但尚不完整。
日益拥挤的前沿领域
Qwen3.8-Max发布于基础模型发展史上节奏最快的时期之一。
数周之内,开发者已陆续见证月之暗面(Moonshot AI)、OpenAI、Anthropic及其他公司推出的重要新版本,各模型分别强调不同优势:推理能力、编程能力、多模态能力、自主智能体能力或经济性。
阿里巴巴的此次贡献尤为突出,因其结合了具备竞争力的基准测试性能、激进的定价策略、百万级token上下文窗口,以及明确承诺为其旗舰模型发布权重。
它能否成为企业级自主智能体的首选平台,最终将更多取决于更广泛的独立验证、生产环境下的可靠性,以及即将发布的权重所附带的许可条款,而非单纯依赖排行榜排名。
这些因素——而不仅仅是基准测试图表——将决定Qwen3.8-Max能否真正成为领先美国专有模型的替代方案,抑或仅是这场日益拥挤的前沿人工智能竞赛中又一个令人印象深刻的参与者。
JOTO 企业落地观察
- 对企业部署而言,Qwen3.8-Max的中端定价(输入/输出合计8美元/百万token)与潜在宽松开源许可形成双重杠杆——若最终采用Apache 2.0类许可,将显著降低企业自托管长周期智能体系统的TCO,尤其利好需规避API依赖与数据出境风险的金融、制造类客户。
- 对智能体工程而言,该模型在OSWorld-Verified(86.1分)和PaperBench(93.0分)的领先表现,首次系统验证了‘跨日级软件工程’与‘多模态反馈驱动执行’的技术可行性,但文中明确指出所有演示均由阿里自制且未被独立复现,提示工程团队须建立严格沙箱验证流程,而非直接迁移生产工作流。
- 对AI安全治理而言,文章揭示关键合规盲区:Qwen3.8-Max开源权重许可条款尚未披露,而参照Moonshot Kimi K3的定制许可(含MaaS商业限制与披露义务),企业法务需前置评估许可证兼容性——若采用限制性许可,将直接影响其在GDPR或中国《生成式AI服务管理暂行办法》框架下的合规部署路径。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们