双11:当 AI 接管支付宝大促交付,模型之外还要建什么?
深度拆解支付宝双11 AI大促交付经验,揭秘模型之外的工程体系建设思路。核心内容:1. 支付宝618、双11大促的刚性时间、高敏感质量等核心业务特征2. 支付宝大促技术团队近三年从工程化到AI全链路交付的技术演进路径3. AI接管大促交付场景下,模型之外所需搭建的支撑体系核心要点
这是2026年的第 76 篇文章
( 本文阅读时间:约 20 分钟 )
01
本文回顾支付宝大促技术团队近三年的演进,介绍如何通过 AI Harness(支撑 AI 研发交付的工程体系),从工程化走向 AI 全链路交付,提升研发效率与质量,并回答一个核心问题:当 AI 接管大促交付,模型之外还需要建什么?
02
(一) 大促特点
-
时间是刚性。
支付宝618、双11的排期和集团大促战略时间强绑定,必须按照既定时间执行,交付窗口以周计、全倒排——“延期”这个选项在大促字典里不存在。 -
质量是底线。
优惠、权益、资金全是高敏感业务,大促期间任何线上问题都处在用户与舆论的放大镜下,事故代价被数倍放大,质量标准只升不降。 -
需求脉冲式涌入。
平时细水长流的业务,大促前集中爆发——横跨直播、互动多个会场与几十个功能模块,短时间内交付密度陡增。 -
唯一不变的是变化。
每年的会场玩法、权益形态、对接方都在换,去年沉淀的经验今年只剩部分适用,再加上每年都有新人进场——体系本身必须能应对“变化”这个常态。
(二) 技术演进过程
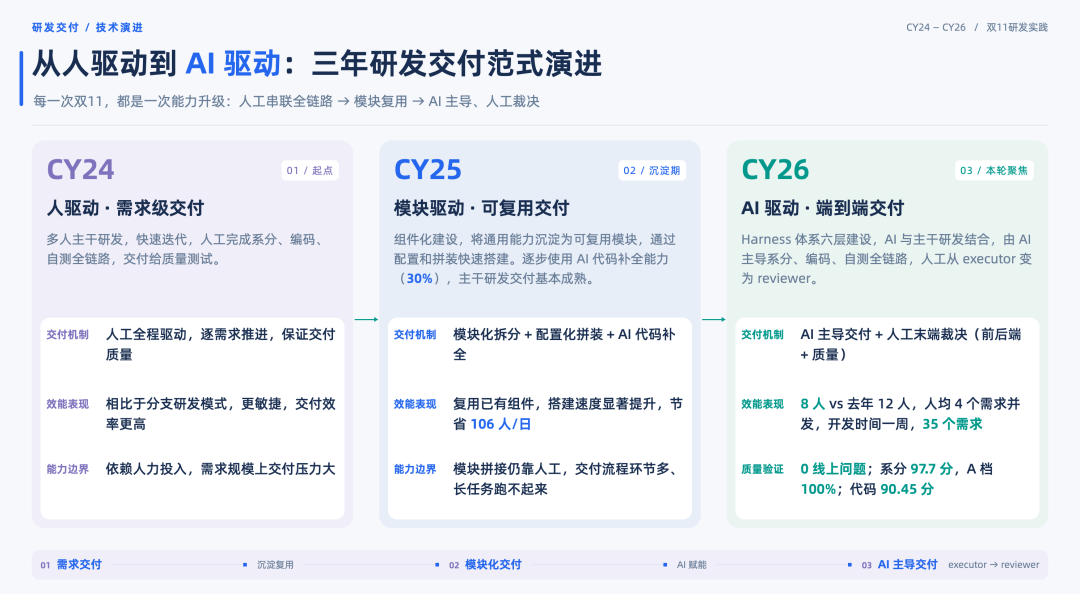
2024年:把需求交付的“又好又快”定义清楚、做到位。快的定义是随时可发布——以主干研发为基础,向主干合入小PR,随时保有可发布版本,发布能力从“一周一发”提升到“一天一发”,并行需求互不等待,接得住大促需求脉冲式涌入的交付密度。好的定义是科学拆分需求,Feature化小步快跑,单次变更控制在800行以内,保证CR质量,严控高风险代码,变更行覆盖和分支覆盖行业领先,达到90%才能合入,第一次大促就做到了线上0故障/0线上问题/0重大舆情,业务目标完美达成。但是也存在不足:当需求规模量级变大,人力投入线性上涨,交付下来不轻松。
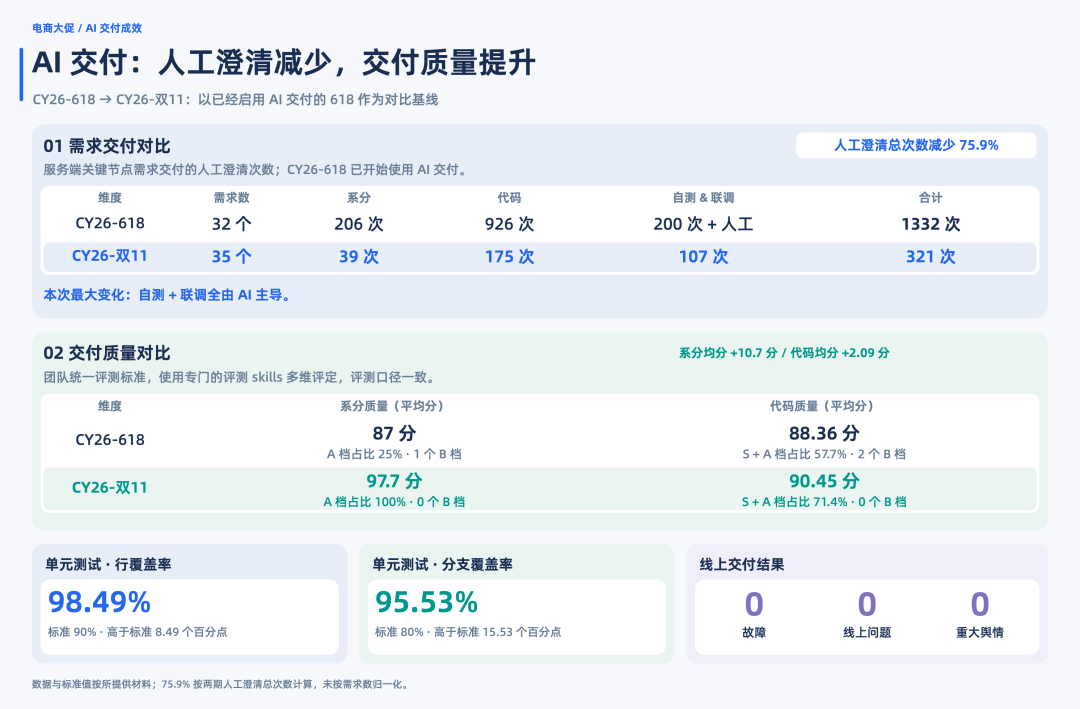
2025年:组件化沉淀 + AI 补全,效率的第一次杠杆。 第一步是把通用能力从需求里抽出来:将签到、抽奖、发奖、弹窗这些大促标配能力沉淀为可复用模块,通过配置和拼装快速搭建会场,当年节省约106 人/日。第二步引入 CodeFuse 做 AI 代码补全和单测生成,AI 生成代码占比逐步达到30%。但补全的本质是“Coding加速器”:写这一下变快了,系分、自测、联调仍一条条是人工,模块怎么拼还是要人来决策。瓶颈没有消失,只是从“写代码”转移到了“串流程”。 2026上半年:Claude Code 引爆 Agent Coding,重新理解 AI 的角色。 关键变化不是代码写得更快,而是 AI第一次能“接活”了——给它一个任务和一份上下文,它能自己读代码、自己改、自己跑测试验证。我们对 AI 的认知从“补全工具”升级为“可以委派的执行者”,这是 AI Coding 与传统辅助编码的分水岭。 2026年·618大促:Agent Coding 的第一次实战,也暴露了裸用 AI 的代价。 CY26-618 我们用 AI Coding 主导交付了 32 个需求,验证了可行性,但代价清晰可见:系分/编码/联调全程人工澄清 1332 次,AI 协作的人力成本全部压在人身上。复盘的结论很直接:裸用 Agent 不可行——AI 产物质量不可控、对业务上下文一无所知,每一分不可控都要人来兜底。 2026年·双11大促:用 Harness 回答这道题。 要让 AI 真正接管交付,光等更强的模型是等不来的,必须在模型外面补上一整套东西:它该看到什么、下一步该干什么、用什么工具动手、出错了怎么爬起来。而这整套东西的原料,正是前两年的工程积累——主干研发练出的CR纪律与质量门禁、组件化练出的复用抽象、评审与评测沉淀的准出标准,它们没有被 AI 淘汰,而是被翻译成 AI能执行的语言,多年软件工程的深入理解与演进经验,在 AI 这里找到了结合点。这个判断也得到业界印证——Anthropic 在《Building effective agents》中提出的 agent 工程化原则,以及 Claude Code、Cursor 等 Harness 的实践都表明:同一个基座模型,套上不同的 Harness,表现天差地别;决定上限的是模型,但把上限稳定兑现的,越来越是模型之外的那一层。这套模型之外的运行框架,业界称之为Harness——这正是我们双11要回答的问题。
03
-
Harness核心解决:让AI在可控的范围内稳定产出各阶段高质量交付产物,高效率
完成需求交付。
Harness 是什么:模型外层的运行框架,环境、工具、上下文、编排、可观测、验证、治理。
业界 |
核心Harness思想 |
OpenAI |
环境即产品,围绕 Codex 设计环境、约束、文档、反馈回路。 |
Anthropic |
架构简单可检查,工具为 Agent 设计,上下文渐进给,长任务可恢复+交接产物。 |
LangChain |
评测是护城河,单步/回合/多轮三层评测 + 可重置可复现环境。 |
结合业界以及我们大促业务特性,大促Harness体系如下:
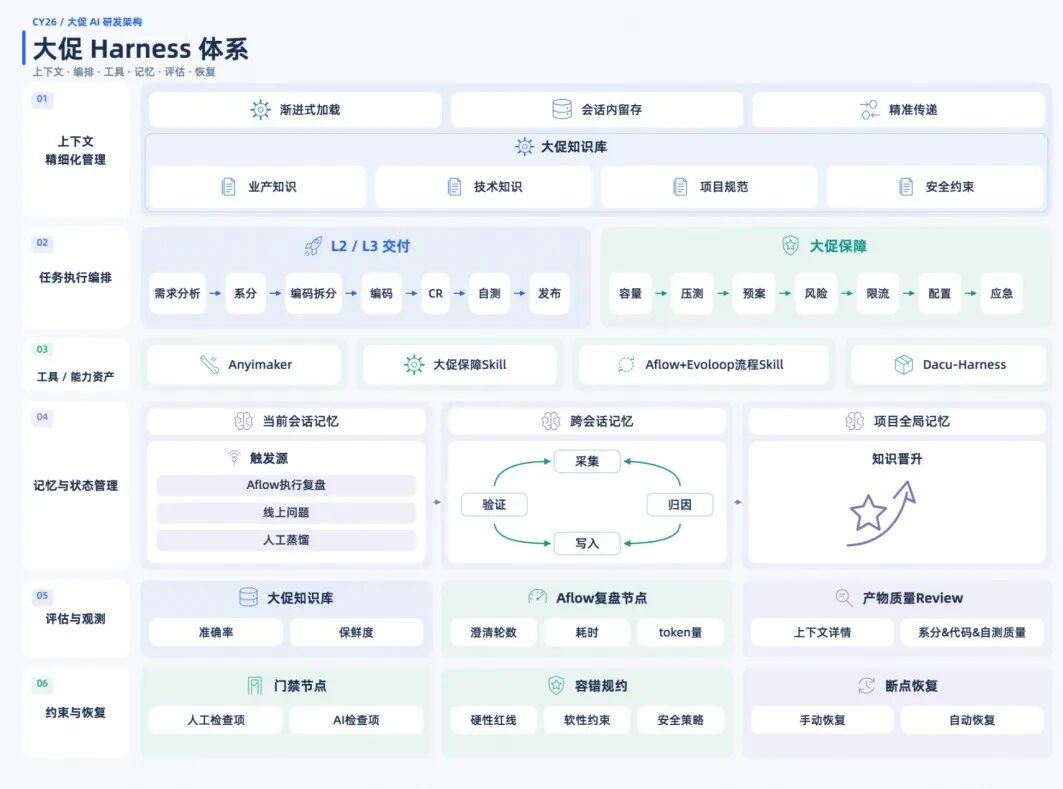
层 |
目标 |
上下文精细化 |
让流程每步拥有「恰好够用且正确」的信息。 |
执行编排 |
把「散装工具的人工串联」升级为可编排的自动流水线,模型知道下一步该干啥,人只做裁决。 |
工具/能力资产 |
让交付线与保障线的每个编排节点都有「够用、可复用」的执行 Skill,且运行环境一致、产物稳定。 |
记忆与状态 |
让跨阶段状态外化可接力,并把澄清与现场经验晋升为知识回流上下文层。 |
评估与观测 |
让 Agent 的工作可量化、可下钻、可归因,优化从「感觉」走向「证据」。 |
约束与恢复 |
让 AI 执行在可控边界内运行——错误结构上不能犯、出错可回退重试,而非靠 AI 自觉。 |
04
(一)建设大促上下文
- 解决问题:AI 与人对大促业务知识断层,导致每次需求都要从零解释业务背景、反复澄清。建
appcampaignocb_kis大促知识库,沉淀为标准事实,作为大促上下文管理的底座。
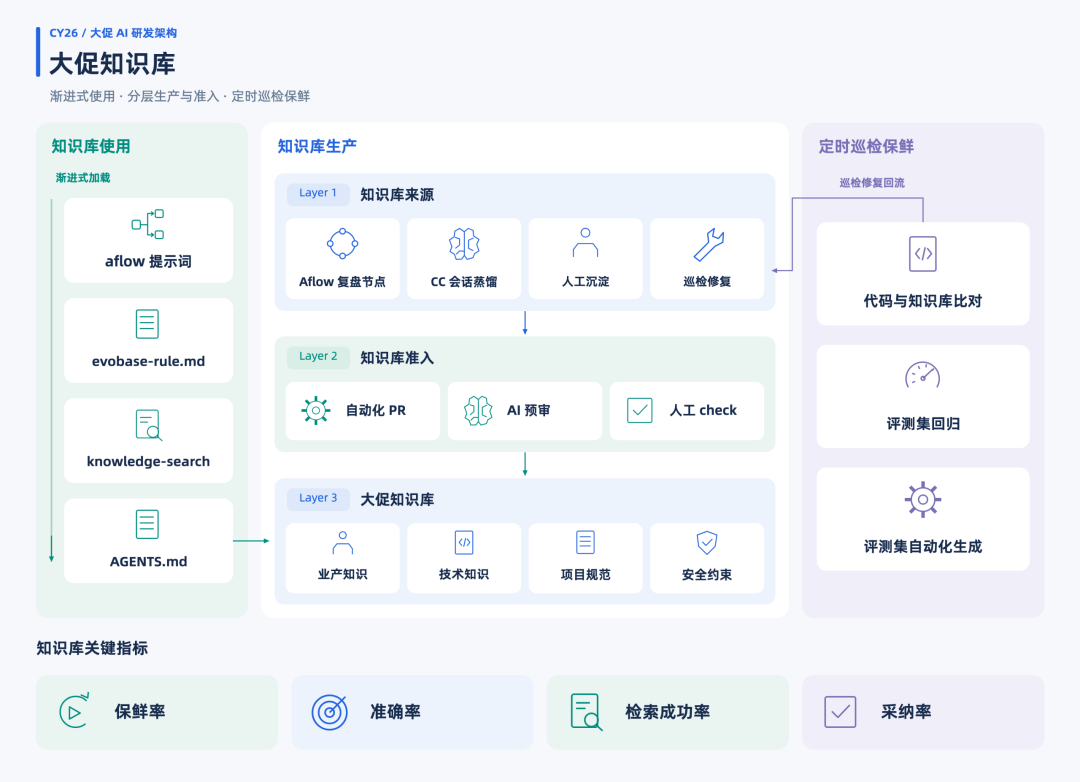
- 知识库生产:现场蒸馏,准入成库。候选知识来自四个触发源——人工沉淀、CC 会话蒸馏、Aflow复盘节点、代码与知识库比对,研发现场出现的澄清与结论都是潜在候选。蒸馏时先过筛选闸门:研究对象属本应用、可复现、无已有覆盖,命中才按六大板块归类套模板成文。入库前走准入门禁——AI预审 + 评测集回归人工 check,合入后同步挂上 AGENTS.md 索引。
- 知识库使用:约束常驻、索引先行、按需召回。三层渐进式加载:规则层随会话自动注入——“编码前必查规范、澄清前必查知识库”是硬约束,不依赖模型自觉;导航层 AGENTS.md 文档地图常驻上下文,先看地图再取正文;召回层 knowledge-search按任务语义检索,不全量灌注。检索命中高置信直接采纳不澄清,中置信确认式提问,未命中才开放问人。
- 知识库保鲜:巡检比对,自动回流。每天跑一次全量巡检,逐篇将知识与代码现状比对,找到过时段落、失真章节与失效结论。偏差自动生成修复PR,走与入库相同的准入门禁,合入即完成一轮保鲜。另有一套按模块出题的评测集持续“考试”,保鲜度与准确率以答题结果度量。
1. 知识库建设经验
环节 |
要 ✅ |
不要 ❌ |
支撑指标(下节) |
内容取舍 |
技术方案与代码保持一致,只存结论与关键决策 |
罗列过多代码详情——保鲜成本高、检索噪音大 |
保鲜率 |
组织方式 |
分模块沉淀 + AGENTS.md 索引导航,全局约束以 ADR 模式全局生效,既要有垂类业务,又有通用知识 |
一篇方案留多个结论,AI 检索到无所适从 |
准确率 |
加载消费 |
渐进式加载:AGENTS.md 索引常驻上下文,规则自动注入,knowledge-search 按需召回 |
知识全量灌进提示词——上下文膨胀、关键事实被稀释 |
检索成功率 |
质量准入 |
版本控制 + 定时保鲜巡检,发现偏差自动提 PR |
AI 自审直接通过,跳过人工 check |
采纳率 / 一次通过率 |
2. 知识库数据表现
知识库的保鲜标准,每天定时播报,低于值就要关注了。
- 规模:知识库累计 122 篇,包括产品知识、技术方案、架构决策、业务术语、测试、问题排查等六大板块。
- 保鲜率:H_fresh = 88.10%(优)全量比对 14 模块,每天定时跑一次全量,发现问题直接提PR。
- 准确率:H_acc= 86.11%(优),统一管理评测集(基于规则生成),14 模块共 196 道问答评测集。
- 采纳率:76.2%,本轮巡检提交的 68 个修复 PR 中,89.7% 已采纳合入,一次通过率 72.1%。
(二)统一大促研发流程
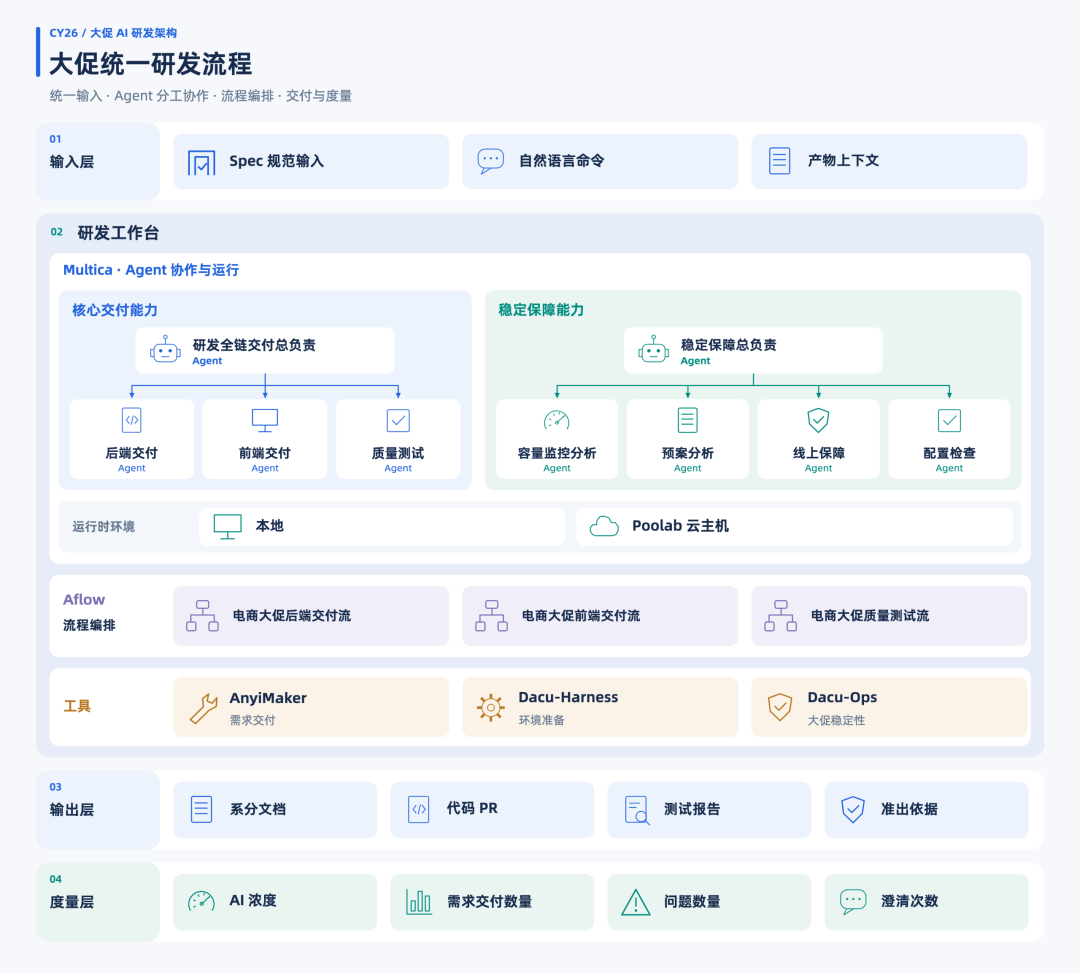
基于上述Harness体系打造,我们定义了大促统一研发流程,研发交付需求采用四层结构。
研发工作台定义就类似我们研发用的IDEA一样,不用关心细节,只关注需求交付即可,与平台共建属于自己研发工作台。
1. Aflow平台
-
基本介绍:
支付宝自研流程编排平台,让 AI 与人按业务自己的流程协作,过程可看见、可感知、可干预。 -
解决问题:
确定性的研发编排流程,将前面Harness体系落地到Aflow各个节点,给了需求交付更多确定性。 - 关键能力:
流程编排 + 产物上传&传递 + 节点级 checkpoint + 后置 Prompt + 钉钉通知。 每个节点都有干净上下文,业务可以自定义prompt,很好解决长任务执行过程中上下文污染和爆炸的问题。
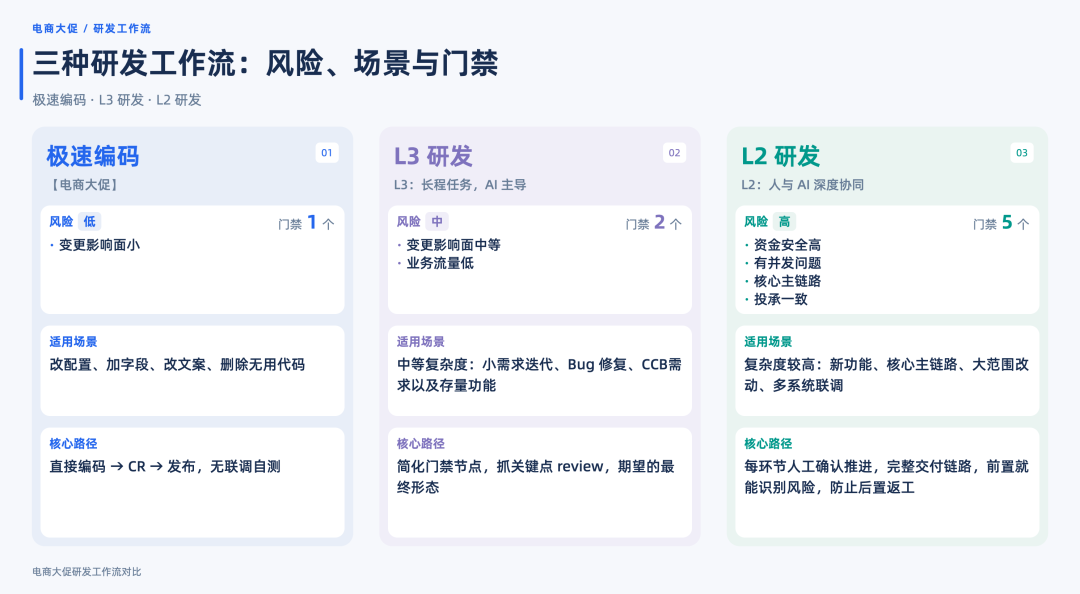
基于大促需求的风险等级拆分的研发模式。
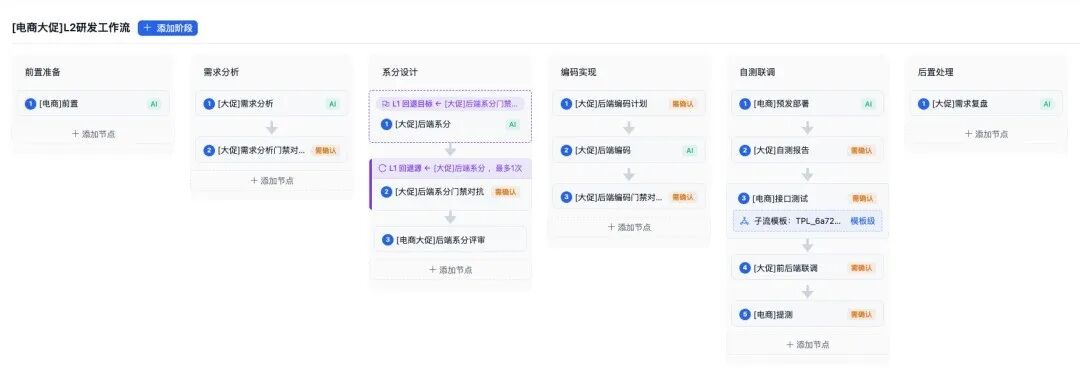
L2研发工作流,如下图所示:
关键经验
各个关键产物都有多Agent对抗性检查。系分、代码以及自测报告都有准出标准,这样才能保证质量。
门禁节点必选。包含了AI预审、约束条件以及项目规范,必须遵守,保障AI产物在可控范围,不跑偏。
断点恢复,重启胜过修补,保证高效执行长任务。状态沉到文件里,Agent 随时可以在一个干净的上下文窗口里接力继续,目前依赖守护进程和Aflow的节点恢复能力。
2. Multica平台
基本介绍:基于开源项目 Multica 改造的内部多 Agent 研发协作平台——以任务(Issue)为载体统一承载需求上下文与过程产物,通过分布式 Agent网络连起个人与团队运行环境,持续适配支付宝复杂多样的业务场景。
解决问题:统一研发界面,开发同学只需要关注产物即可,不需要关注是多少个Aflow节点在运行了。
关键能力:
多issue并行,一个issue对应一个需求,开发同学可以并行运行多个需求,解决大促需求集中且多的问题。
Agent 与运行时解耦,开发可以自由选择在本地和云端执行需求交付,不用本地电脑一直开着。
多 Agent 协同:覆盖前端、后端、质量等多角色,很好承接 Aflow 的三档研发流程。
L3小队(端到端交付)实践
L3小队协同把「后端全自动」升级为「全链路全自动」,把人工串联的环节收进编排。 - 关键目标:结合 Multica 多 Agent 协同能力,重点解决改动不大的存量功能,释放更多人力去做新的需求。
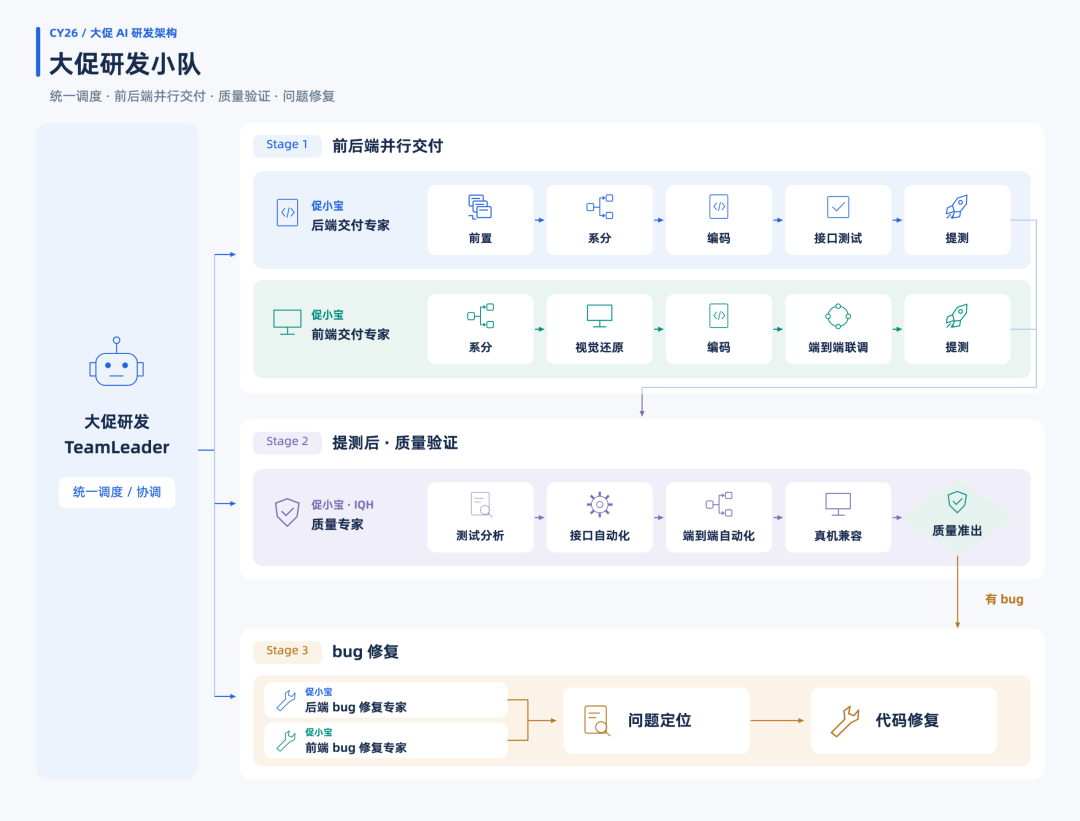
一次需求交给一个 Agent 小队:TL 负责调度,后端、前端、质量三个交付角色按棒接力,每棒产物 review 齐全才算交棒。质量不通过自动进 BUG 修复循环,连续两次不过才升级人工。人只做两件事——验收和机器跑不动时的协调。
(三)关键工具能力持续打磨
1. 系分工具:从“AI 味”到过得了评审
-
痛点:
系分是大促交付链的第一环,也是协同面最宽的产物——前端、质量、SRE、下游系统都照着它干活,评审不过就是全链返工;而大促需求脉冲式涌入、全程倒排,留给写系分的时间被挤压。裸用 AI 写系分有四个顽疾——信息收集不全、图表制作繁琐、技术选型不靠谱、文档质量不可控,AI 味重到评审直接打回,返工反而更慢。 - 怎么做:
-
先建尺子:
蒸馏 24 年至今工程研发的系分思路与优秀产物特性,固化为模型的编写参考与准出标准,AI 照着最好的样子写,Reviewer 按同一把尺子判。 -
定死分工:
人做决策、AI 做执行。架构分层、技术选型等关键决策动笔前由人拍板,AI 负责信息整理、图表生成、文档组织,避免“AI 写 AI 看”。 -
管住过程:
渐进式确认。信息收集 → 资料分析 → 大纲 → 关键决策 → 逐章撰写 → 准出审阅 → 发布,每步有明确输入输出与确认点,方案先行于写作,方向错了当步拉回。 -
守住终点:
独立 Reviewer Agent 按推导过程、架构合理性、技术专业性等六维度评分,不达标循环修改—质量是检查出来的,不是期望出来的。
2. 编码工具:Loop 出来的高质量 MR
-
痛点:
大促代码踩在高危区——发奖、权益、资金链路上,事务、并发、幂等、弱依赖兜底一处不能漏,还要扛住峰值的限流降级要求。而模型输出是概率性的——代码三分钟写完、看着像模像样,细看暗伤一片:事务内直接调下游、一锁二判三更新没走、ThreadLocal 不做清理、只让改 A 却顺手改了 B。用规范和流程做约束后仍有漏网:MR 通不过静态检查、Agent 干到一半自认完成、改了动态配置代码却漏掉了配套的默认值声明,运行时直接报错。根因是单次交互难以稳定产出高质量交付物。 - 怎么做:
-
先立铁律:
把“想好了再动手”做成结构约束,上下文未确认不写代码、骨架未批准不写实现、审查未完成不交付。任何一项未通过就回退重来,模型在结构上无法跳步。完整自审查清单源自 2457 个真实 PR 的 1833 条 CR 评论加蚂蚁军规,按 P0/P1/P2 分级逐项过——不再是“请仔细检查”式的空泛嘱咐,历史踩过的每一条坑都变成模型的必答题。 -
再上 Loop:
铁律降住了暗伤,降不住概率。于是编码被做成Loop,输入明确,系分+编码计划前置,人的澄清全部前移到编码前,产出编码计划;准出客观,单元测试与CR预审以业务用例为判断依据,双通过才放行;过程不依赖人,两路检查的问题以报告形式流转回编码,自动修复重试。 -
确定性的事交给确定性工具:
贯穿两代的底层原则——Gate 检查用 Shell 脚本强制执行、编译验证跑真实 mvn、PMD 升级为 JavaParser+AST 脚本判断。概率模型做概率擅长的事,脚本保证确定性。
3. 测试工具:从人工构造 case 到 AI 全自动自测
-
痛点:
大促下游依赖较多,逻辑复杂,各种营销活动发奖、淘宝跨域咨询等,没有自动化工具,完全依赖人去构造资产和case,再去进行自测,不仅效率低,而且容易漏掉case,特别是端到端基本是人来执行。 - 怎么做:
-
分层推进:
单元测试验证代码逻辑(关注分支与行覆盖)→ 接口测试验证输入输出行为 → 端到端测试串联完整业务链路——三层互补不互替,逐层向后收网。 -
真实请求数据回放:
端到端测试与本地测试工具打通,把预发真实请求拉到本地回放——接口正确的前提下,不再反复造数联调。 -
知识库托底:
预发测试资产、接口前置准备、端到端测试 case 沉淀进知识库,前置准备从“每次手工攒”变成“按需取用”。 -
报告结构化生成:
自测报告由 AI 按标准骨架产出,每条测试用例带编号与“预期结果 + 实际结果 + 判定依据”三件套,判定依据落到配置单据、日志断言与trace留痕——覆盖情况可检查,每条结论可复核。
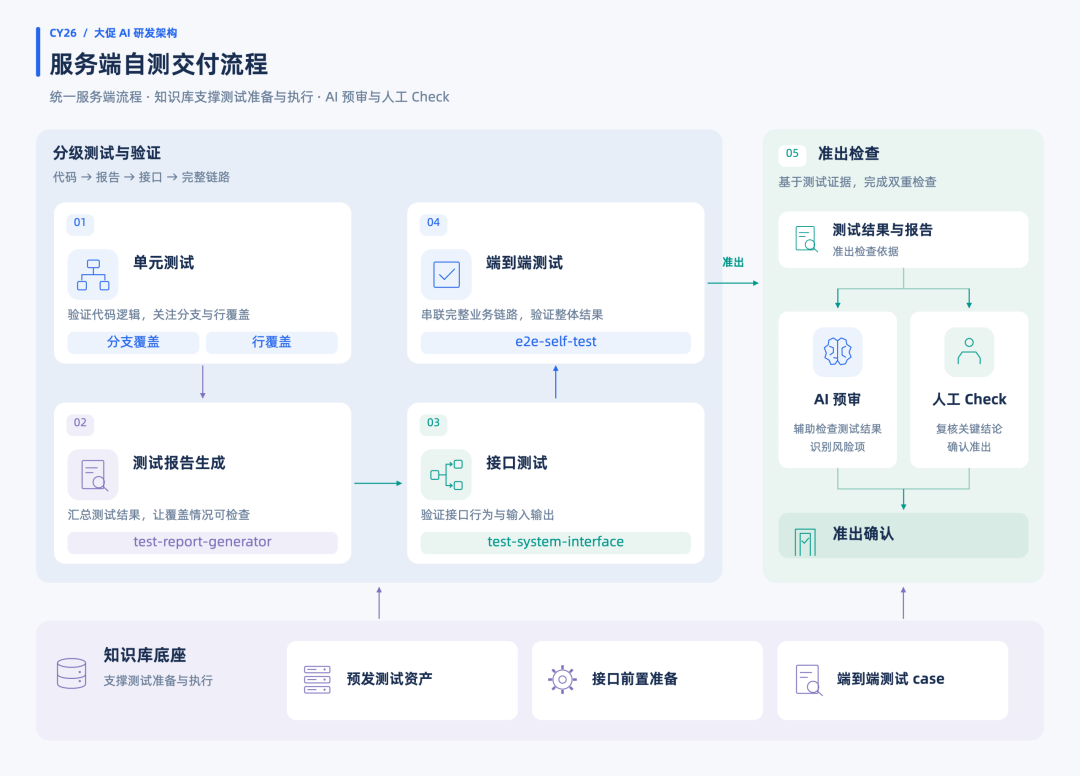
-
实践案例:
单个case端到端测试流程,大概3~6分钟可以跑完一个case(复杂程度),支持多次/循环执行。
预读知识库+自测报告,获取用户case以及真实请求的数据。 拉起本地的测试工具(模拟器),按照用户case模拟点击行为,返回服务端接口测试数据,前端进行渲染。 截取关键动线图,进行对比(关键截图、日志以及返回数据),对比成功之后,自动回写自测报告。
(四)大促Harness自进化能力
痛点:Harness 不是一次性搭完就定型——研发现场每天都在暴露新的澄清、断链、知识缺口,靠人工逐条优化不可持续。 解决问题:建自进化闭环把现场问题自动转化为 Aflow 提示词 / 工具 / 知识库的改进,全链路自动流转、人工仅末端裁决。 触发链路:每次一个需求完结,回收运行时详细数据,实时生成采集报告,T+1提出PR,T+2合入发布(含人工review)。
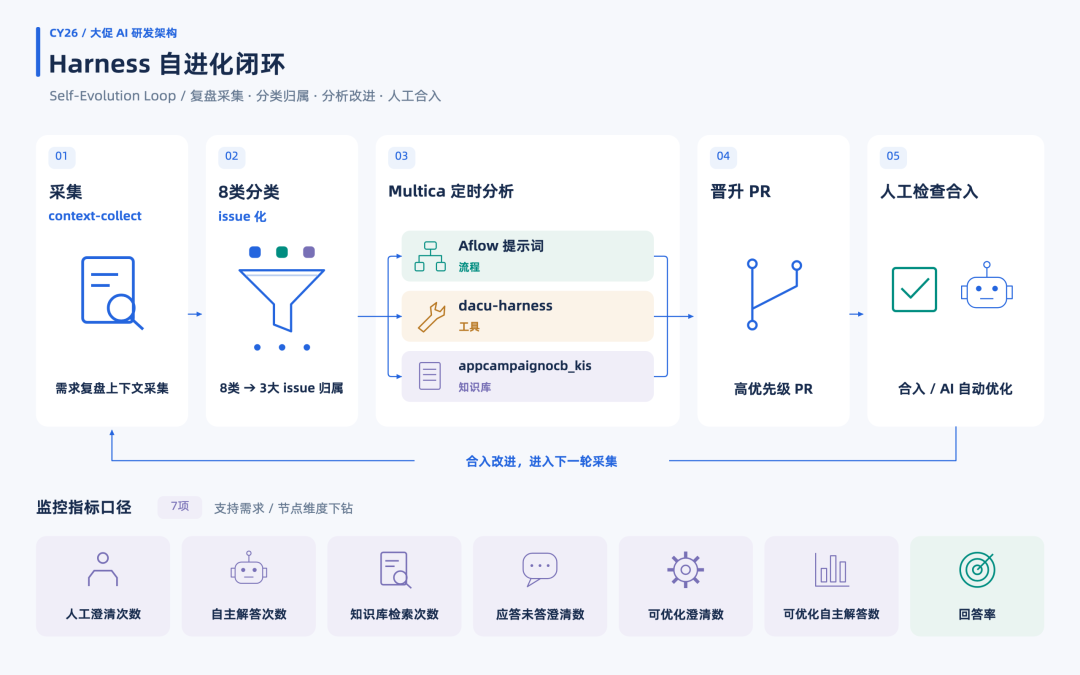
具体步骤
-
需求完结,自动采集
每个需求复盘节点完结即触发采集任务,回放主会话与子 agent 会话,按统一口径产出「上下文观测报告」——不靠人回忆,现场证据完整落盘。 -
指标提取,问题清单化
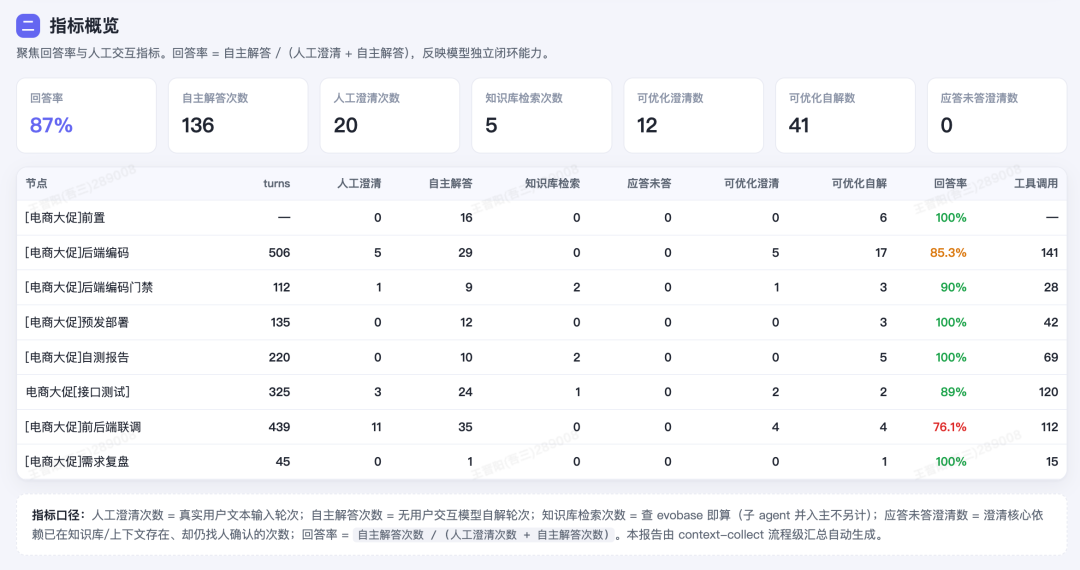
从会话中提取 7 项运行时指标(人工澄清次数、可优化澄清数、应答未答澄清数、自主解答次数、可优化自主解答数、知识库检索次数、回答率),把模糊的“这次跑得不好”翻译成可归因的问题清单。 -
定时分析,分类归属
定时任务逐份分析观测报告,按问题分类,归属到三大改进面(运行时关键改进面):Aflow 流程(节点提示词)、大促工具链以及大促知识库。 -
分支路由,改进自动化
知识缺口 → 直接走知识晋升流程,蒸馏结论自动提 PR;流程与工具问题 → 建立 issue 打标签进队列,按优先级排期。 -
人工裁决,末端把关
所有 PR 经 AI 预审 + 人工 review 后合入,人工只出现在链条末端——低风险改动快速过,高风险改动重点看。 -
回流生效,进入下一轮
改进后的大促 Harness 在下一个需求交付中重新被采集与度量,好没好用让数据说话,形成「交付→观测→改进→交付」的自驱动飞轮。
自进化当前数据效果
真实需求35个,进行了35轮自进化,5轮大的迭代,针对Aflow流程发现有效issue 51 个,排除非通用、重复等issue,落地优化PR 12个。
05
CY26-618大促已经开始使用AI交付了,所以与618数据比较最合适。
06
(一)支撑全新营销活动 0→1 搭建,优化 Harness 体系
-
现状局限:
当前 Harness 体系建在双11存量会场之上,需求以「模块迭代」为主,知识库沉淀的也是存量模块的标准事实。换成全新营销活动从零搭建,知识库无可检索、系分无可对照,体系优势会大幅衰减。 -
知识库冷启动机制:
新业务进场即自动蒸馏 PRD、系分、评审结论入库,边交付边沉淀,让知识随需求「长出来」,而不是等活动结束再人工补录。 -
落地验证场五福:
计划把整套大促 Harness 体系运行到 CY27五福上。五福相对大促是全新活动类型,正好作为新场景验证,重点打磨「架构先行」的并行编排模式——总体系分作为门禁先行,再拆子需求Aflow流并行,把全局架构约束注入每个子需求上下文,保证并行产物与整体设计一致。
(二)Harness 自进化:可视化、更及时
-
现状局限: 当前闭环节奏为需求完结 → T+1 采集报告 → T+2 PR 合入;35 轮自进化产出 51 个有效 issue,仅 12 个落地为 PR,时效偏慢、有效转化率偏低。
-
更及时: 采集从需求级后置复盘,前移到节点级实时触发;低风险优化(提示词调优、知识修补)AI 直接自动合入,人工只裁决高风险与跨模块改动,闭环周期从「天级」压到「小时级」。
-
issue 质量提升: 51 → 12 的落地差主要来自非通用、重复类 issue,加强自动去重与分类的准确率,让有效 issue 更多转化为改进。
-
可视化: 建自进化看板——澄清轮数、知识检索命中率、issue 分类流向、PR 合入状态、知识保鲜度实时可观测,趋势可见,暴露断链不再依赖人工翻采集报告。
-
平台化输出: 与Multica深度合作,体系成熟后向其他业务团队复制推广,从大促专有走向通用能力,比如五福需求交付环节。
07
业界正在形成共识:Agent 工程的演进是五层叠加:Prompt → Context → Harness → Loop → Graph。Harness解决完“活得稳”之后,竞争焦点上移到第四层 Loop Engineering——你不再逐轮提示 AI,而是设计一个自己发现工作、执行、验证、改进的循环。正如 Claude Code 负责人 Boris Cherny 所说:I don't prompt Claude anymore. My job is to write loops.
先讲清两者的区别:
-
Harness Engineering
相当于把一个新手上路要出的每一步险都兜住——交规手册时刻提醒(上下文精细化)、限速和车道约束防跑偏(门禁与规范)、安全员坐副驾随时踩刹车(human in the loop)、出了事故有拖车和返厂维修(约束与恢复)。它回答的是:这一趟,能不能安全到达。 -
Loop Engineering
把视角从“一趟”换成“一支车队”:车自己接单、自己跑、跑完自动回场检修,把每天的行驶数据自动转化成第二天的驾驶策略。它回答的是:这支车队,怎么持续地跑、越跑越好。
我们目前的位置:第三层半,human in the loop。 六层 Harness 体系已建成——交规、约束、安全员、事故维修一应俱全。自进化闭环也已具 Loop 的雏形:需求完结触发采集、自动分类提PR、知识晋升。但循环的每一圈都要人推。往 Loop Engineering演进,本质就是把“必须由人确认”的环节收敛到最小,把副驾上的安全员逐步请回站场,只在他真正需要出现的地方拦截,两个方向已经在探索实践了:
-
高风险代码的自动化检查与修复闭环
资金安全巡检目前是每日定时巡检 → 自动识别 → 提 PR 等人合入,发现是自动的,闭环是断的。往 Loop 演进的目标是把“发现—修复—验证—回归”整链接上:编译、单测、评测集这些机器能判的直接自动通过,人只抽检资金幂等、并发锁这类真正的红线,让高危代码问题以小时级被发现并修复。 -
基于线上问题的自动解决闭环
大促值班目前的问题定位 agent 止步于“给出根因”,处置仍在人。演进方向是补全后半段:定位 → 生成处置方案 →低风险操作(开关回滚、配置调整)自动执行、高风险止损保留人工确认 → 处置结果归档、经验沉淀回知识库。值班人力从“执行者”退到“裁决者”,同一个问题第二次出现时循环应该自己接住。
大促工程师的角色转变已经悄然发生:从对着 AI 逐条澄清需求,到设计约束、验证规则与改进循环。
Build the loop, stay the engineer.

立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们