阿里Qwen4-Max:成本显著下降但综合智能仍落后前沿竞品
阿里巴巴发布专有模型Qwen4-Max,宣称任务成本降低62%,支持百万token上下文与多模态输入,但Benchmark显示其在编程、视觉及综合智能指数上明显落后Opus、Gemini等前沿模型,且未开源权重。
阿里巴巴为其最新旗舰AI模型提出了一个务实的主张:企业应能以更低的成本完成更多工作,即便该模型并未在整体智能排名中领先。
该公司 Qwen4-Max的发布 推出了一款支持文本、图像和视频输入、可与外部软件协同工作、并能处理高达一百万token上下文的模型。阿里巴巴表示,该模型在Qwen3.8-Max基础上实现改进,同时将其内部Work360评估中每项任务的平均成本从4.43美元降至1.67美元,降幅约为62%。
Qwen4-Max作为专有模型发布,并非开源或开放权重版本。 Artificial Analysis将其归类为专有模型,且阿里巴巴尚未提供可供企业下载并在自有基础设施上运行的权重文件。客户可通过 QwenCloud API访问该模型,或在 Qwen Studio、 QwenWork和 Qoder中使用。
对于一个以 发布开发者可下载并适配的模型而闻名的模型系列而言,这是一个具有实质意义的区别。阿里巴巴的 发布声明 承诺将开源发布更小规模的Qwen4模型,但未给出具体时间表或许可证类型,也未对Max版本作出同等承诺。截至本文发布时,我们未发现阿里巴巴公开承诺发布Qwen4-Max的权重文件——亦无明确声明称其将永久保持闭源。当前,该旗舰模型为专有模型;已公布的开源模型路线图仅涉及更小规模的版本。
API收费标准为每百万输入token 1.50美元、每百万输出token 4.50美元。这些费率低于Anthropic、OpenAI和Google多家知名厂商的若干主流替代方案,尽管单凭token价格本身并不能决定一项完整任务的最终成本。
性能表现则更为复杂。Qwen发布的图表显示,该模型在若干专业及长程工作任务基准测试中结果具备竞争力,但在其他编程与视觉任务上存在显著差距。一项独立综合评估亦将该模型排在领先美国竞品及月之暗面(Moonshot AI)Kimi K3.1 Pro之后。
对于企业买家而言,Qwen4-Max提出了一种面向特定工作负载的主张:潜在的经济吸引力与实用能力并存,但在准确性、响应速度及部署选项方面存在实质性差异。
更低的价格与更少的token消耗共同构成了效率主张的核心
阿里巴巴的 Work360框架 将专业工作划分为26个广泛领域、182个子领域及721个专业细分方向,其示例包括会计审核、制造业分析、法律事务及文档生成。
Qwen4-Max在该公司基准测试中得分为52.69,高于Qwen3.8-Max的47.74分。这一提升为4.95分,较先前得分相对提高约10.4%。
阿里巴巴报告称,在Work360测试中,Xhigh推理设置下的token消耗量下降约24%,High设置下下降35%。在Terminal-Bench 4.0测试中,对应降幅分别接近48%与49%。
这些是彼此独立的发现。约50%的token减少量源自终端测试;62%的成本降低则来自Work360,反映的是token用量与定价两方面因素。二者均无法确立适用于客户全部工作负载的普适性节约比率。
亦有独立证据表明经济效益得到改善。 Artificial Analysis对Qwen4-Max的评估 报告其每项Intelligence Index任务成本为3.27美元。其 对Kimi K3.1 Pro的评估 报告该项成本为3.68美元,据此Qwen在此指标上约便宜11%。这些数据源自不同于阿里巴巴1.67美元结果的测试套件,不应视作可互换。
API价格对比情况
以下价格涵盖标准API使用场景,单位为每百万token的美元金额。Qwen数据源自其新加坡区域定价;Google数据为全球统一费率。批量折扣、工具调用费用、区域溢价及企业协议均可能改变实际对比结果。
模型及定价来源 | 输入 | 输出 | 缓存输入 | 重要说明 |
|---|---|---|---|---|
1.50美元 | 4.50美元 | 0.075美元 | 缓存费率适用于符合条件的缓存命中 | |
$4.00 | $20.00 | $0.20 | 标准 Claude API 费率 | |
$2.00 | $10.00 | $0.10 | 标准全球费率 | |
$2.00 | $10.00 | $0.10 | 输入 token 数量超过 272K 后,输入/缓存费率翻倍,输出费用升至 $15 | |
$2.00 | $10.00 | $0.10 | 截至 11 月 30 日的入门级定价;此后为 $4/$20/$0.20 | |
$1.50 | $7.50 | $0.075 | 标准全球费率 | |
$2.00 | $10.00 | $0.20 | 由 Artificial Analysis 报告的费率 |
Qwen 的输出费率为 $10(即标准 Sol、Sonnet 及入门级 Carbon 使用所收取的标准费用)的 55% 以下,且比 Opus 5.5 低 77.5%。其输入费率与 Hydrogen 相同,而输出费用则低 40%。
但 Qwen4-Max 并非所有应用场景中成本最低的选择。 Anthropic 的价目表 将 Haiku 5.5 列为:对于最多含 100,000 个 token 的提示,输入费为 $0.10、输出费为 $0.50;超出该阈值后,输入费升至 $0.50、输出费升至 $2.50。买家仍需自行确定哪款模型能可靠完成其工作任务。
Qwen 还对显式缓存创建单独收费:五分钟缓存为每百万 token $1.875,一小时缓存为每百万 token $3,读取费用为每百万 token $0.075。较低的缓存输入费用不应被套用于请求中的每个 token。
其单独的 Token Plan 订阅服务 为新客户宣传促销入门价,低至 $3。该订阅优惠,以及单独列出的 qwen4-max-preview 折扣,均不应与标准 qwen4-max API 定价混淆。
智能体基准测试展现了优势——以及明显局限
智能体必须做的不只是生成看似合理的响应。它还需调用工具、解读结果、调整方法,并交付可用成果。Qwen 的 发布对比测试 针对该流程的多个环节进行了测试,结果各异。
基准测试 | Qwen4-Max | Qwen3.8-Max | Opus 5.5 | GPT-6.1 Sol | Kimi K3.1 |
|---|---|---|---|---|---|
DeepSWE v1.1:编码智能体 | 75.7 | 69.3 | 74.2 | 75.2 | 75.5 |
Terminal-Bench 4.0:终端工作 | 48.5 | 38.9 | 59.6 | 56.1 | 67.2 |
ProgramBench:软件复现 | 31.5 | 28.0 | 65.0 | 52.5 | 25.0 |
APEX-Agents v1.1:专业服务 | 72.1 | 63.3 | 73.5 | 60.0 | 65.5 |
AutomationBench-AA:软件工作流 | 72.5 | 56.2 | 69.5 | 64.9 | 73.3 |
ChartoGraphy:图表理解 | 54.2 | 42.0 | 66.3 | 67.8 | 50.0 |
这些数据复现了Qwen的图表(含其Kimi标签),并非独立重跑结果。阿里巴巴的脚注将部分分数归因于外部评估方,包括Mercor和Artificial Analysis,并对其他分数说明了具体设置或数据集版本。
Qwen在所展示的DeepSWE结果中以微弱优势领先,且在APEX-Agents上接近Opus。它在Agents’ Last Exam v1.1上的得分为46.7,而其前代模型为27.9,Opus为43.4。
然而,其Terminal-Bench结果大幅落后于Kimi,ProgramBench得分亦不足Opus的一半。评估自主软件维护系统的采购方,不应以某一项有利的编码得分替代对该系统必须执行的各项运维任务的全面证据。
图表阅读能力的差距同样关乎金融与文档分析类工作流。
整体智能水平仍落后于领先者
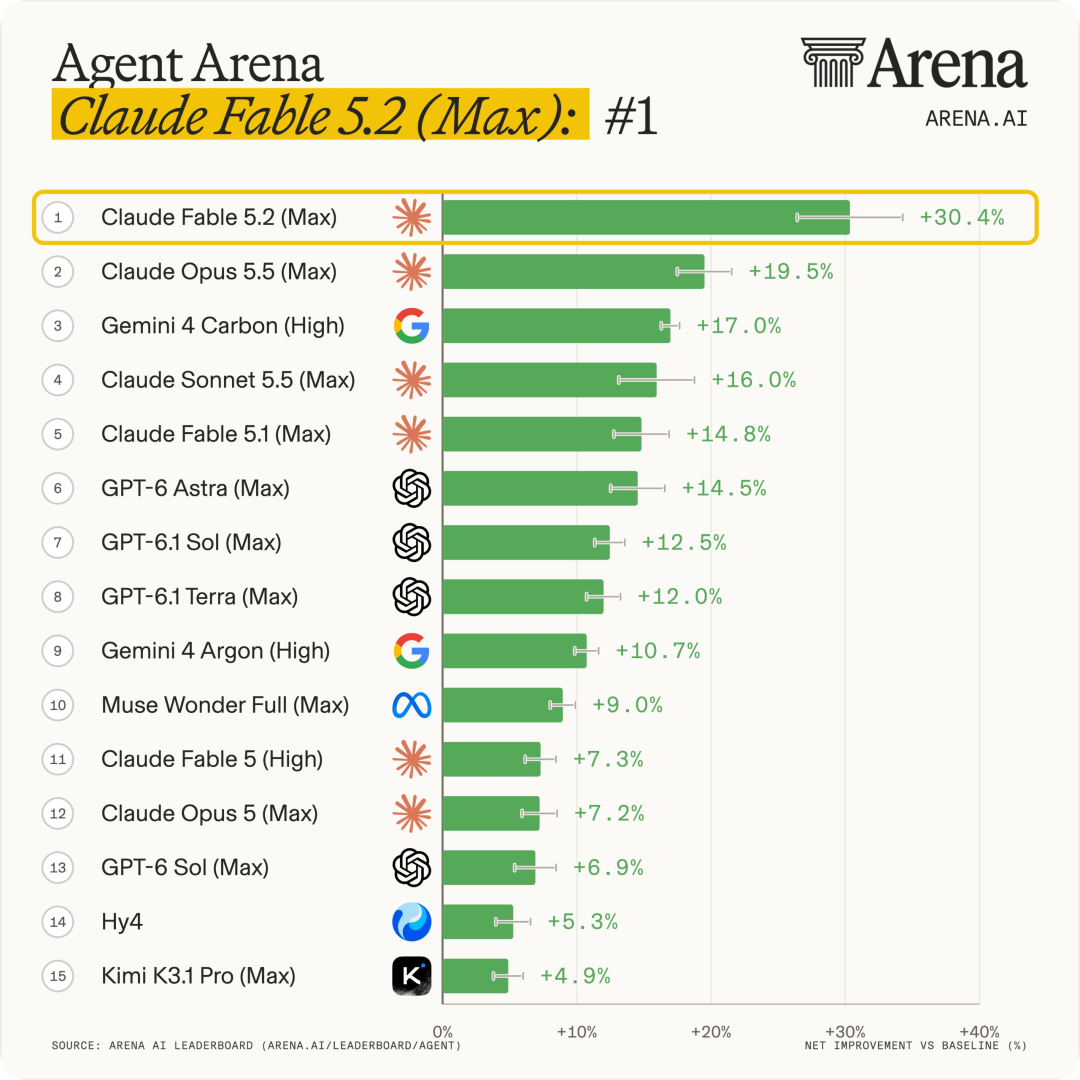
Artificial Analysis发布的启动图表显示,Qwen4-Max在其智能指数(Intelligence Index)上得分为43,高于Qwen3.8-Max的34分;Kimi K3.1 Pro得分为46;GPT-6.1 Sol与Claude Sonnet 5.5均为55分;Opus 5.5达59分;Gemini 4 Carbon为60分;Claude Fable 5.2则以65分位居该展示组首位。
这些数值代表图表中所示的推理配置,而非必然对应各模型的默认设置。
这一综合图景限定了对阿里巴巴所选任务结果最强有力的解读:Qwen可在特定任务上紧密竞争,但在聚合指标上仍明显落后。
此外,它的响应速度略慢:在本次评测时, Artificial Analysis的模型页面 报告其每项智能指数任务耗时约32分钟,首词元(first answer token)生成时间约为159秒,处于主流基础模型中更耗时的一端。
这些测量值针对其严苛的评估负载及测试配置,不表示其在每次响应中的实际表现。但它们仍警示:不可将成本降低等同于交付提速。
支持多模态输入,但不具备原生媒体生成能力
该 QwenCloud 规格 列出了文本、图像和视频输入,以及文本输出,但不支持音频输入,也不原生支持图像、音频或视频输出。
这一区别澄清了发布演示的内容。Qwen 在 3D 工作中使用 Blender,在交互式软件中使用游戏引擎,并在视频制作工作流中使用 WonderClip。通过软件工具制作影片,与模型直接生成视频存在本质差异。
竞争对手的边界各不相同。 Opus 5.5 接受文本和图像输入,并返回文本。 GPT-6.1 Sol 同样列出文本和图像输入,不将音频和视频列为原生模态,尽管它可以调用图像生成等工具。 谷歌的 Carbon 和 Hydrogen 规格列表 包括文本、图像、视频和音频输入,以及文本输出。Artificial Analysis 将 Kimi K3.1 Pro 列为支持文本和图像输入。
因此,对于以录制语音为中心的应用,Qwen 已公布的规格要求采用不同于谷歌具备音频能力模型的集成方式;对于视觉检测或视频分析,Qwen 提供直接输入选项,但相关准确率及处理限制仍有待测试。
更大规模的架构旨在降低活跃计算量
阿里巴巴描述了一种 2.4 万亿参数主干网络,其中每个 token 激活 710 亿参数,另有 3280 亿参数专用于局部 token 模式表征。因此,2.4 万亿这一数字并未完整计入该附加组件。
其混合专家(mixture-of-experts)设计每次仅激活网络的一部分。结合压缩历史与选择性注意力机制,旨在使长输入更经济高效,而经修订的信息通路则支持训练稳定性。
阿里巴巴称,该模型激活的参数数量比 Qwen3.8-Max 约少 25%。其预训练图表还报告了知识、代码、问答及 STEM 领域预测分数的提升。这些测量指标描述的是预测性能,而非任务完成成功率;阿里巴巴指出,该对比混合了基础模型检查点与后训练检查点。
实际问题是:这些架构变更能否以可接受的成本产生可靠的工作成果?仅凭参数数量无法回答这一问题。
各方反应揭示了对“成功发布”的不同定义
此次发布已引发批评,焦点在于所选基准测试结果与更广泛排名之间的差距。在本文审阅的一张截图所展示的帖子中, X 账户 Chubby(@kimmonismus)写道:“Qwen 4 并非一次成功的发布。”
该账户认为,Artificial Analysis 的结果削弱了其与 Opus 表面相当的并驾齐驱地位,并推测蒸馏限制解释了性能差距。所附帖子未提供任何证据确立该因果解释;仅凭基准测试分数本身无法确定模型训练数据获取方式如何影响其性能。
独立成本测量支持一种更为审慎的评估:Qwen 在整体智能水平上落后于 Kimi,但每项评估任务的成本更低。这对处理大规模工作负载的企业可能至关重要,即便这并不确立其处于前沿领导地位。
可用性、开源权重及企业决策
Qwen4-Max 可通过 QwenCloud、Qwen Studio、QwenWork 和 Qoder获取。其 API 列表包含工具调用、结构化响应、网络搜索、批量处理,以及与 OpenAI 和 Anthropic API 格式的兼容性。
阿里巴巴还描述了一种“实时交付”(Live Delivery)工作流,可向用户暴露可用的中间结果,使其能在代理完成前重定向其行为。该公司表示,将把相关插件作为开源软件发布。
但与许多前辈不同,Qwen4-Max 并非开源权重模型。阿里巴巴承诺将发布更小规模的 Qwen4 版本,并提供可下载的权重,但此次公告既未说明其许可证类型,也未公布发布时间表。希望在自有基础设施上运行该旗舰模型的组织,不能将这一未来承诺视作当前可用。
制造与科学演示雄心勃勃。阿里巴巴报告称,某机械加工工件的手动编程耗时从约 475 分钟减少至 24 分钟;并描述了一次为期 48 小时的材料研究运行,成功产出了一种实体冷却剂样品。这些均为公司自行报告的演示,并非证明类似节省或发现将在客户实际部署中普遍重现的证据。
Qwen4-Max 最明确的企业机会是可量化的:测试其较低费率与改进的执行效率是否能降低产出合格结果的成本。该计算应涵盖重试次数、审核时间、外部工具使用及延迟等因素。其最强的基准测试结果为其评估提供了依据;而其较弱的结果则使得针对具体工作负载的验证变得必不可少。
JOTO 企业落地观察
- 对企业部署而言,Qwen4-Max的API定价优势(输出费仅为Opus的22.5%)与Work360框架下任务成本下降62%构成明确经济动因,但其闭源属性、无本地权重交付、响应延迟高(首token达159秒)意味着企业无法自主优化或保障SLA,仅适合对成本敏感且容忍延迟的非核心工作流。
- 对智能体工程而言,Qwen4-Max在APEX-Agents和DeepSWE等专业服务与编码智能体任务中表现接近Opus,但在Terminal-Bench(终端操作)和ProgramBench(软件复现)上大幅落后,表明其工具调用链路稳定性与长程推理鲁棒性存在瓶颈,需针对性验证而非直接替换现有智能体底座。
- 对FDE落地而言,阿里巴巴强调的制造业编程耗时从475分钟降至24分钟等案例属单点演示,未披露可复现条件;其Work360评估覆盖721个专业细分方向,但实际企业FDE需跨系统集成、审计合规与人机协同闭环,而Qwen4-Max缺乏音频输入、原生媒体生成及缓存策略透明度,限制其在金融文档分析、工业质检等关键场景的端到端可用性。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们