Hermes LLM Wiki知识库
Hermes 内置 LLM Wiki 工具,可将散落的文档自动编译为结构化、可演化的知识网络。它通过语义分析提取概念与实体,增量构建持久 Wiki 库,并与 Obsidian 图谱联动。与传统 RAG 不同,LLM Wiki 具备记忆性、答案完整性与主动进化能力,支持命令行一键初始化及双向同步部署。
知识库自动生成:从文档到网络
Hermes 内置了 LLM Wiki 这套工具,能把一批文档自动编译成结构化的知识网络。文档越进越多,概念页之间互相引用,网络的密度自己往上长。知识库不用再自己动手,只管提问和翻看就行了。
解决文档割裂的根本痛点
用 LLM Wiki 的理由不在记笔记的习惯上,在文档本身。
文档、笔记、网页收藏,攒着攒着就散在各处,没有统一标准,想找一条得先猜它在哪个工具里。笔记软件、文档系统、AI 问答工具之间数据又是割裂的,谁也用不上谁。
靠手动整理去补,干过的人都有体会。耗时耗力,结构还僵,搜起来照样慢。更麻烦的是遗忘,几个月前看过的资料,早就不记得自己存过。
LLM Wiki 换了个做法。文档交出去,它自己读完、自己编成一张互相引用的网络,人要做的只是提问和翻看。
整条路走四步。文档先进去,大模型读完做语义分析,再提出概念、实体和它们之间的关系,增量地建成一个持久的 Wiki 库,最后接上 Obsidian,把这张网画出来。
这四步里我能插手的地方只有两步,第一步和最后一步。中间那两步是它自己走的。
与 RAG 的本质差异
关于知识库,之前讲过 RAG RAGFlow。两者确实都在解决「让 AI 用上我的资料」,但做法差得远。
📊 传统 RAG 对 LLM Wiki
记忆。RAG 没有,每次提问都从零开始;LLM Wiki 是持久的,一次一次往下攒
答案。RAG 给出的答案碎,因为它基于临时检索;LLM Wiki 是真正读完文档再整理
进化。RAG 被动,新知识进来它不主动更新;LLM Wiki 主动,增量更新已经存在的页面
差别最大的是最后一条。RAG 每次都是一次性的,问完就散。LLM Wiki 会留下东西,文档越多,页面之间引用的线越密,这张网自己会长。
还有一点不一样。这套东西整理的时候要过一套规则文件,哪些该写、哪些不能动、格式怎么定,都写在里面,库不会被写乱。
建库:一条命令启动全流程
Hermes 里内置了这套工具,不用另外去拉仓库装。直接输斜杠命令,它会一步步带着走。
/llm-wiki #引导式创建
/llm-wiki 创建知识库,关于****的话题
跟着提示选主题和路径,它就把骨架铺好了。
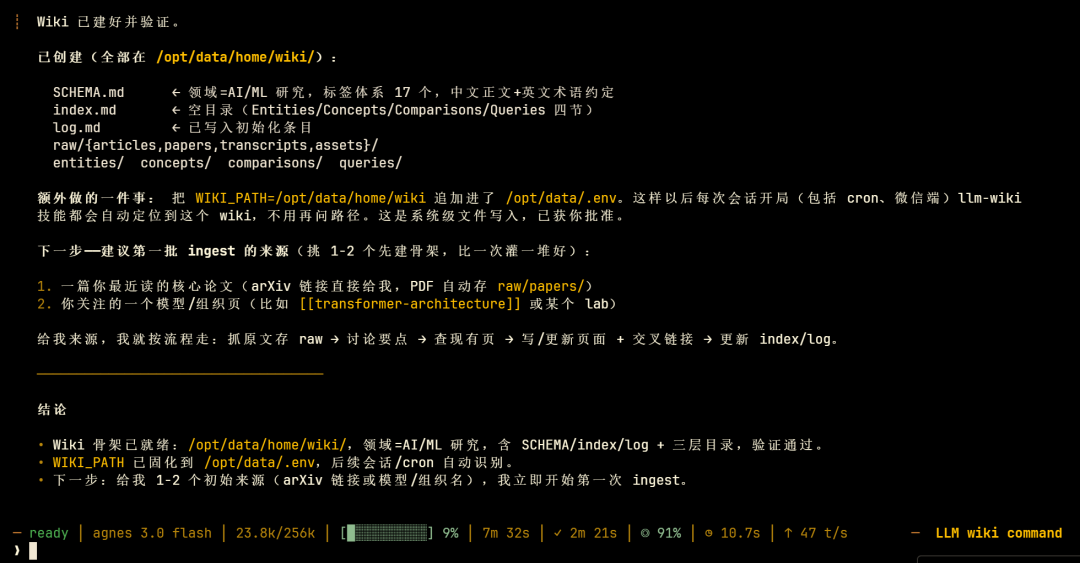
铺出来的东西比我想的细。
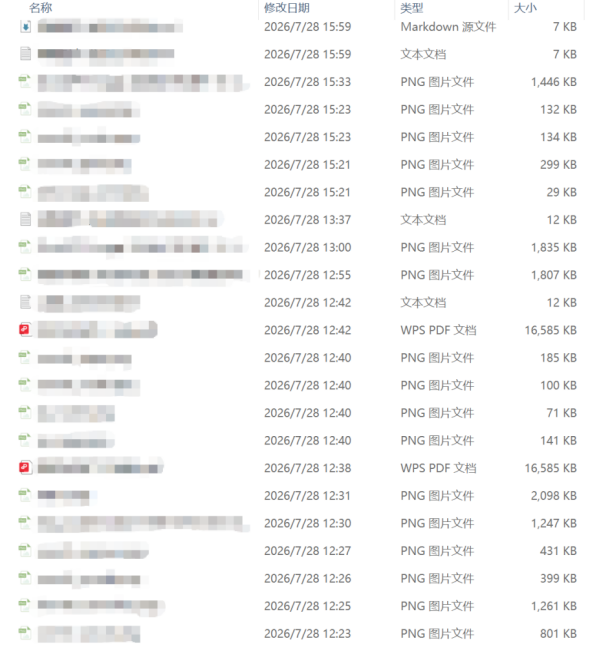
除了 SCHEMA.md、index.md、log.md 三个文件,还有 raw 和四个分类目录。raw 放原始资料,另外四个分别装实体、概念、对比和查询。
它还顺手做了一件事,把 WIKI_PATH 写进 /opt/data/.env。这样以后不管是定时任务还是从微信发起,都能自己找到这个库,不用每次报路径。
路径定在 /opt/data/home/wiki,落在我极空间的挂载卷里,这一点很关键,重启容器它也不会丢。
库在容器里,我平时在电脑上干活,还得让两边看到同一份东西。
极空间这个装法挂不了卷,走的是文档同步,把电脑上的一个文件夹和极空间里的 wiki 目录设成双向同步,改哪边都一样。
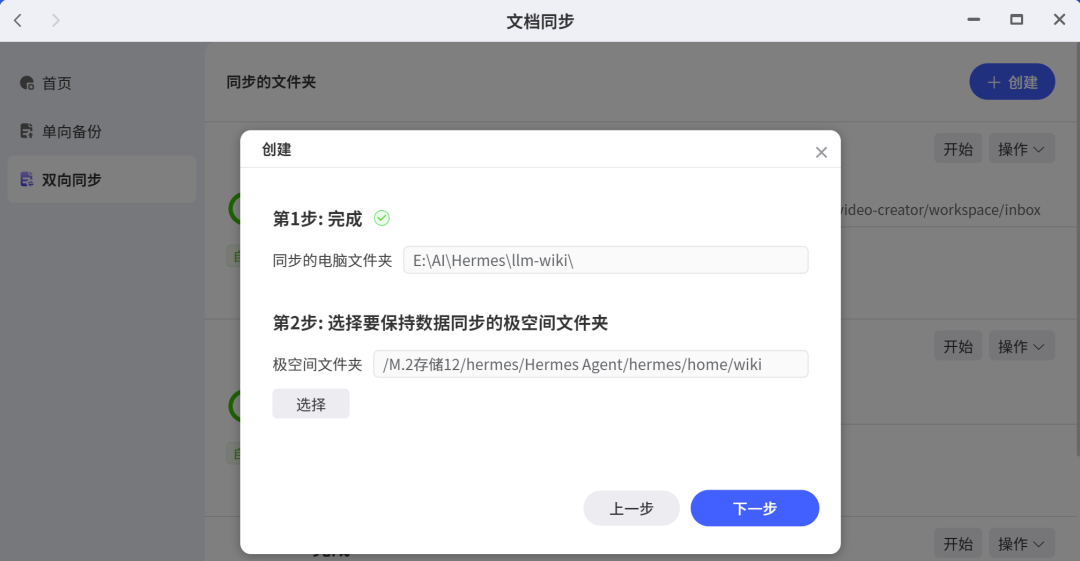
这一步不做也能用,但库就成了一个只能隔着网页看的东西。接上之后,我能在电脑上直接翻、直接改。
首次 ingest:15 篇笔记生成 16 个概念页
把 15 篇机器学习的基础笔记丢进 raw,让它跑第一次 ingest。
跑完它报了两组数。16 个概念页,从线性回归、决策树、聚类一直排到卷积和循环神经网络。还有 60 多处交叉引用,两两之间互相链上。
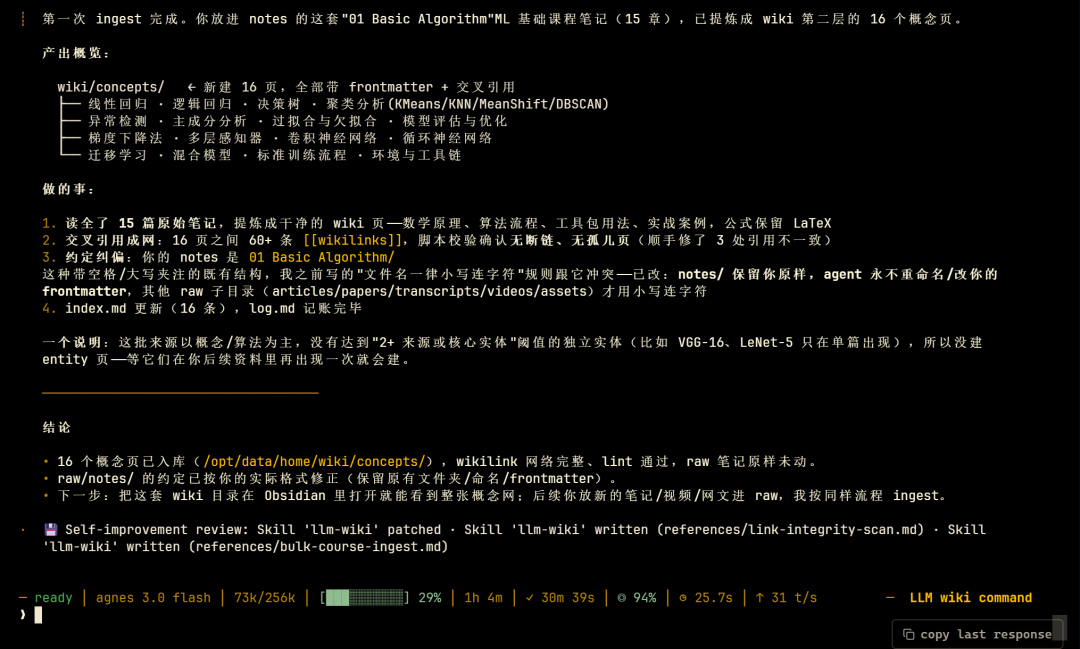
中间它自己修了三处引用对不上的地方,还把索引和日志一并更新了。
有一件事值得单说。我那批笔记的文件名带中文和大小写,跟它默认的小写连字符规则正好冲突,它没有硬套规则,而是保留了我的原样,只给新生成的页面用它的命名。
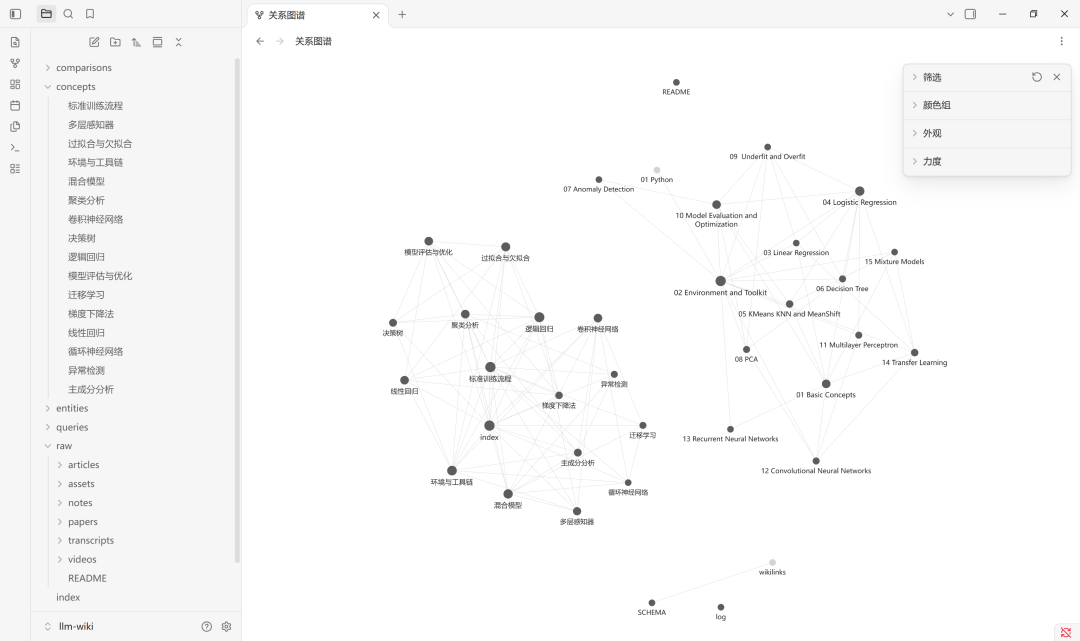
最后它在 Obsidian 里打开的图谱是两个簇。左边一簇是整理出来的中文概念页,右边一簇是我原来那些英文笔记,wikilink 把两簇连在一起。
知识库自主演进:从手动触发到自动更新
库建好只是第一步。我不想每次都手动喊它更新。
做法是建一个知识管理员的 profile,专门管这个库,再挂一个定时任务,raw 里有新内容或者有会话进来,就触发一次更新。
到这里,搬砖的活基本交出去了。我负责往里放东西,它负责把网编密。Hermes 可以调用知识库,我可以通过 Obsidian 查看知识图谱。
Hermes Agent
Pi Agent
CodeX
WorkBuddy
JOTO 企业落地观察
- LLM Wiki 的增量更新与规则文件驱动机制,为企业 RAG 知识工程提供了可预期的治理路径:它不依赖人工反复清洗与标注,而是通过预设规则约束知识沉淀过程,降低因自由编辑导致的语义失真风险,适合需长期维护且责任明确的业务知识库。
- 该系统将知识网络构建与前端可视化(Obsidian)解耦,意味着企业可在不改变现有协作工具的前提下,叠加结构化知识能力。这对已有 Confluence 或 SharePoint 的团队而言,降低了知识工程的迁移成本与组织阻力。
- LLM Wiki 在极空间 NAS 上的落地表明,其设计天然支持离线、低算力环境部署。这类轻量级知识引擎适合在安全隔离要求高、或网络条件受限的分支机构中,作为 FDE 驻场共创的知识基座原型快速验证。
- 知识库‘自动编译’而非‘临时检索’的特性,意味着企业需重新评估知识服务的 SLA 边界:它不再承诺单次问答响应速度,而是承诺知识网络的持续完备性与跨会话一致性,这对客服、培训等需长期记忆支撑的场景更具适配性。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们