相关文章
533 篇高质量内容
Qwen3.8-Flash:全新架构,更强更稳更划算
Qwen3.8-Flash多模态MoE模型发布,全新架构提升性能与效率,支持1M token超长上下文,千问平台即将上线服务。核心内容: 1. 多维度架构升级:GDN+QSA Hybrid Attention、Gated Residual等优化 2. 超长上下文能力:原生262k token,YaRN扩展至1M token 3. 成本与生态布局:训练成本降至前代1/9,千问API及开源Next架构
DeepSeek小模型长了眼睛,Agent基准干翻顶级闭源模型
DeepSeek轻量多模态模型V4-Flash-Vision-Exp,在Agent基准测试中击败顶级闭源模型,视觉与文本性能双优且成本可控。核心内容: 1. 多维度基准测试成绩优异,Agents' Last Exam、ZeroBench等超闭源模型 2. 视觉能力叠加后文本性能未降,DeepSWE、Toolathlon等任务成绩提升 3. 轻量架构+成本控制,Agent工作流能力增强,多场景实用价值显著
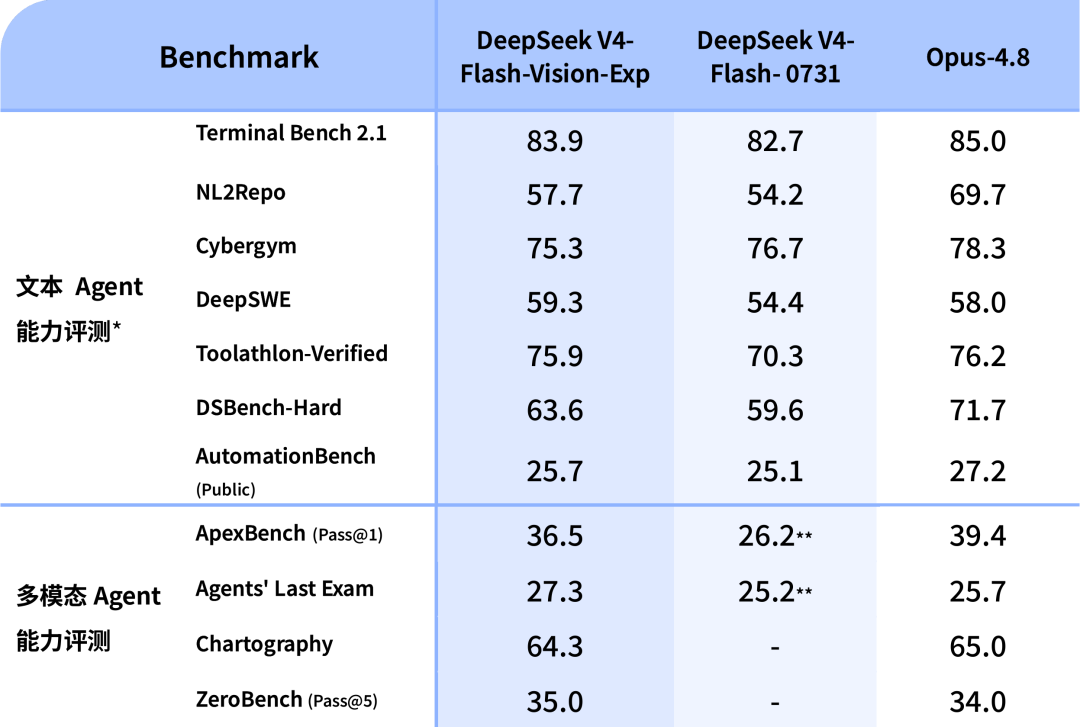
V4-Flash-Vision-Exp 上线,开启多模态 API 服务
DeepSeek-V4-Flash-Vision-Exp多模态模型上线API,文本能力持平正式版,视觉理解Agent能力大幅跃升接近Opus-4.8。 核心内容: 1. 文本与多模态能力平衡(纯文本能力持平,视觉理解Agent能力跃升) 2. 多模态能力解锁的Agent场景示例(商业PPT、开发者网站、动态特效创作) 3. API服务使用方式与计费规则(token计费,价格与V4-Flash一致)
DeepSeek Harness 更新:官方多模态支持
DeepSeek Harness三次版本迭代,多模态能力重磅升级,子代理协作更灵活,体验与稳定性全面优化!核心内容:1. 多模态能力增强(新增多模态模型,支持图文输入及图片持久化)2. 子代理与插件组合灵活(子代理接入Job Panel,插件可注册设置卡片)3. 稳定性与体验持续提升(修复问题,优化交互细节)
DeepSeek终于长出“眼睛”,V4 Flash视觉模型上线
DeepSeek V4系列首支视觉模型上线,支持图片输入,补齐Agent感知入口,参数价格细节曝光。核心内容:1. V4 Flash视觉模型核心参数(支持图片输入、1M上下文、384K输出、JSON等功能)2. 价格策略(与Flash版本一致的缓存及输出价格)3. 与Agent系统整合(接入Harness,联动模型、工具与执行链)
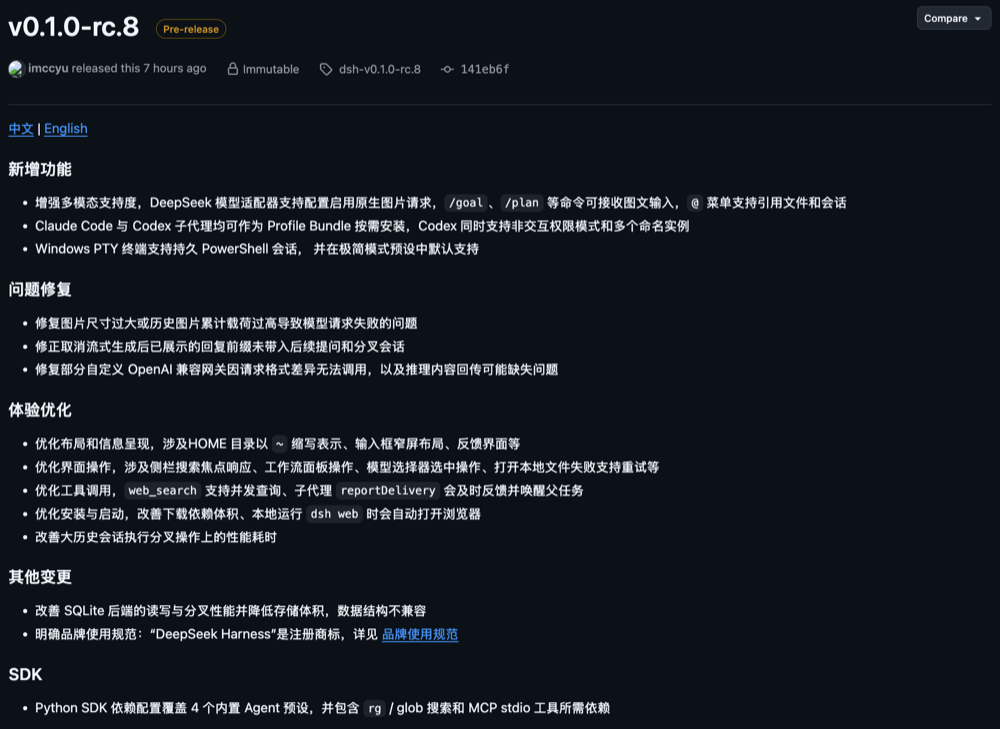
昨夜,DeepSeek Harness首发新版本:14项更新,多模态能力拉满!
昨夜DeepSeek Harness发布v0.1.0-rc.8版本,14项更新补齐多模态能力,子代理与工具体验全面升级! 核心内容: 1. 多模态输入能力升级(原生图片/图文混合支持) 2. Claude Code、Codex子代理体系扩容 3. 终端体验与工具调用问题修复优化
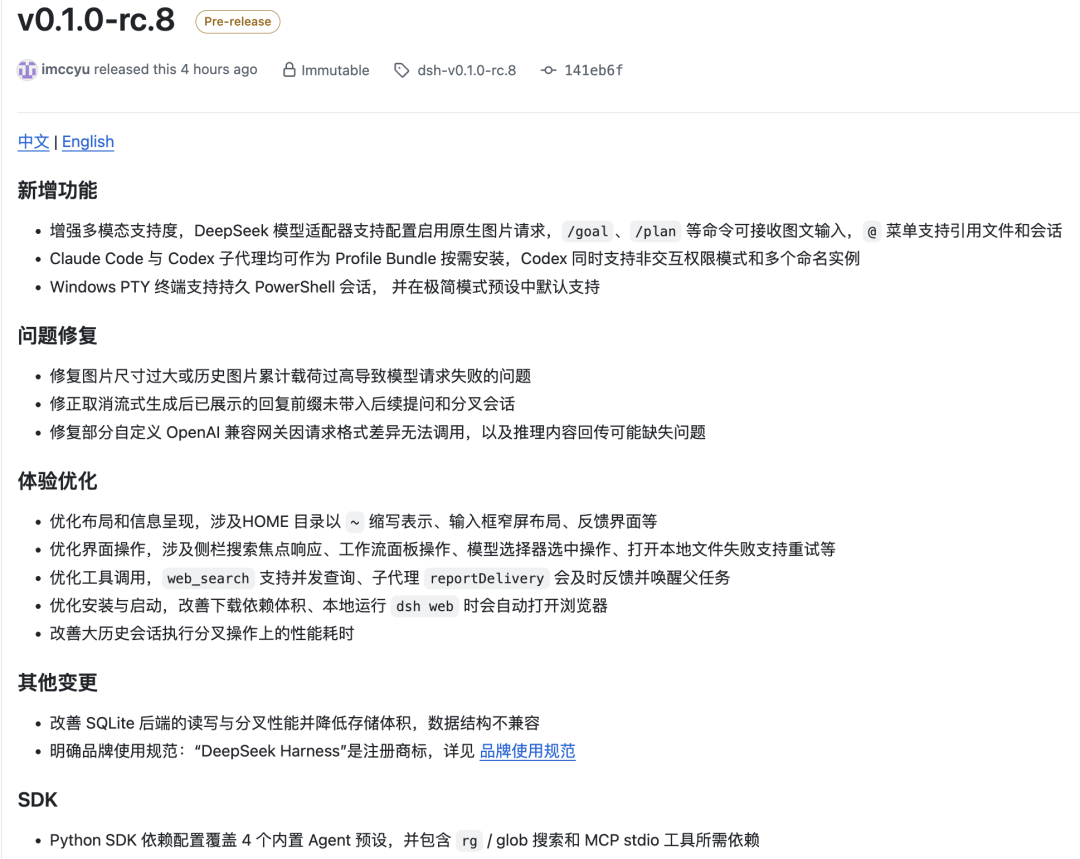
DeepSeek Harness重磅更新:原生解锁多模态
DeepSeek Harness RC.8版本重磅更新!多模态能力原生解锁,Claude Code/Codex子代理按需安装,框架体验全面升级。 核心内容: 1. 多模态与子代理增强:原生图片请求、Claude Code/Codex子代理支持 2. 关键问题修复:图片载荷过高、流式生成前缀丢失等问题解决 3. 体验与工具优化:布局信息呈现、并发查询支持及安装启动改善
GitHub又火了一个语音转录库,我跑了5分钟
本地语音备忘录开发不再崩溃!transcribe.cpp基于ggml,统一C/C++底层+多语言接口,5分钟实现跨平台分发。 核心内容: 1. 本地ASR跨平台分发的痛点(模型拼接、格式转换难题) 2. transcribe.cpp的设计方案:统一底层+多语言接口 3. v0.1.0版本的关键能力(模型覆盖广、后端支持多、验证严格)
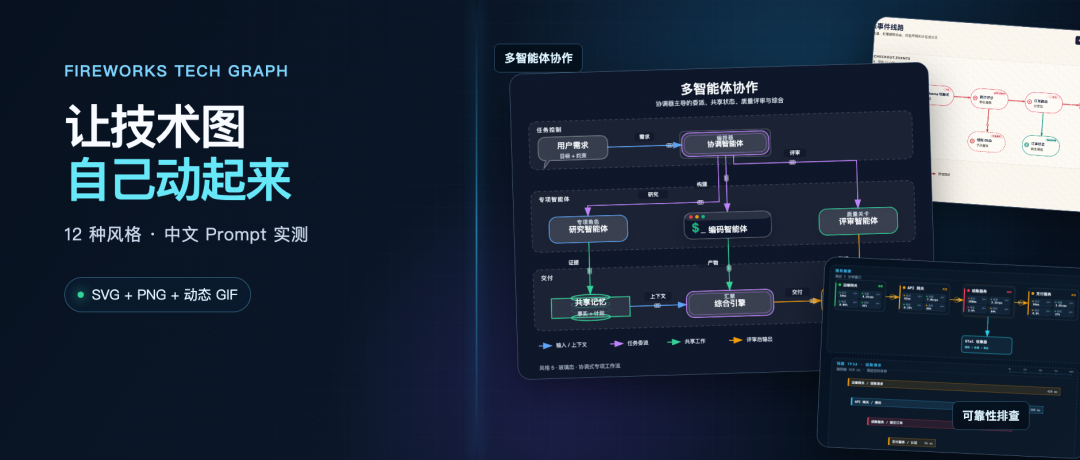
写一句中文 Prompt,技术架构图自己动起来了
用中文描述系统,直接生成可编辑的SVG和动态GIF技术架构图,让箭头按业务逻辑流动起来。 核心内容: 1. 项目核心:解决手动画技术架构图慢且易错的问题 2. 技术亮点:将需求转为结构化语义,生成可校验的SVG与动态GIF 3. 应用场景:覆盖14类UML图及多种AI场景,提供12种视觉风格
腾讯 Miora 正式发布,设计工作也可以交给 AI 了
腾讯Miora让AI接管品牌设计全流程,从定位到视觉资产一键生成,设计师的创意伙伴来了。 核心内容: 1. Miora作为腾讯AI设计Agent的核心功能与使用流程 2. 支持品牌、影视、电商等多场景的模板化创作 3. 智能规划、多模型协同与交互式修改的三大优势
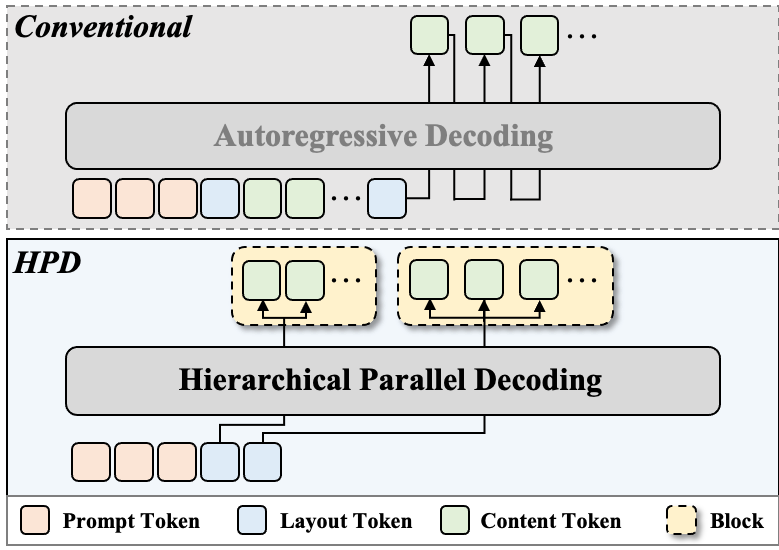
告别逐字等待:PaddleOCR推出高吞吐层级并行文档解析技术 HPD-Parsing
告别传统文档解析的低效串行模式,PaddleOCR推出HPD-Parsing技术,实现团队协作式并行处理,解析效率大幅领先。 核心内容: 1. 传统自回归解析的瓶颈与HPD-Parsing的并行解析机制 2. 在OmniDocBench评测中实现吞吐量三倍以上提升,解析精度保持领先 3. 文档越长,其并行处理的效率优势越显著,代码与模型已开源
TMAP平台图生视频推理加速实践
TMAP平台通过多卡并行、Attention加速、量化与缓存优化,在保证质量无损的前提下实现4.87倍推理加速,单次成本降至0.15元/秒以下。 核心内容: 1. 针对图生视频模型推理瓶颈的四大优化领域 2. 关键加速技术:序列并行、SageAttention算子与混合量化 3. 自研DPCache缓存方案带来的全局最优调度效果
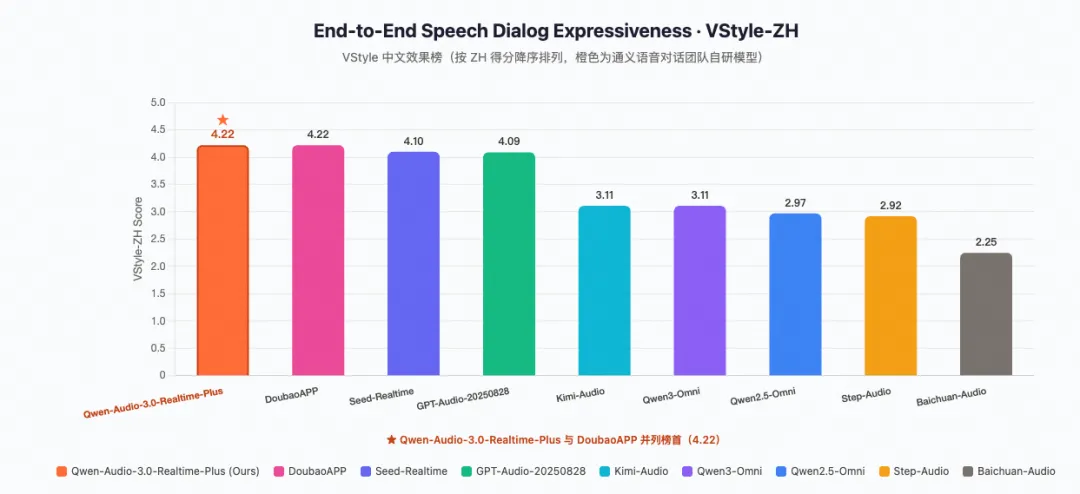
Qwen-Audio-3.0-Realtime 如何让语音交互“懂倾听,更聪明”?
阿里新一代实时语音模型如何让AI“听懂人心”?通过动态情感与多模态双工,实现拟人化交互。 核心内容: 1. 高表现力与共情对话:动态调整语气情感,支持音色克隆 2. 流畅双工交互:多模态感知,嘈杂环境下抗干扰 3. 智能任务处理:动态工具调用,超越基础聊天功能
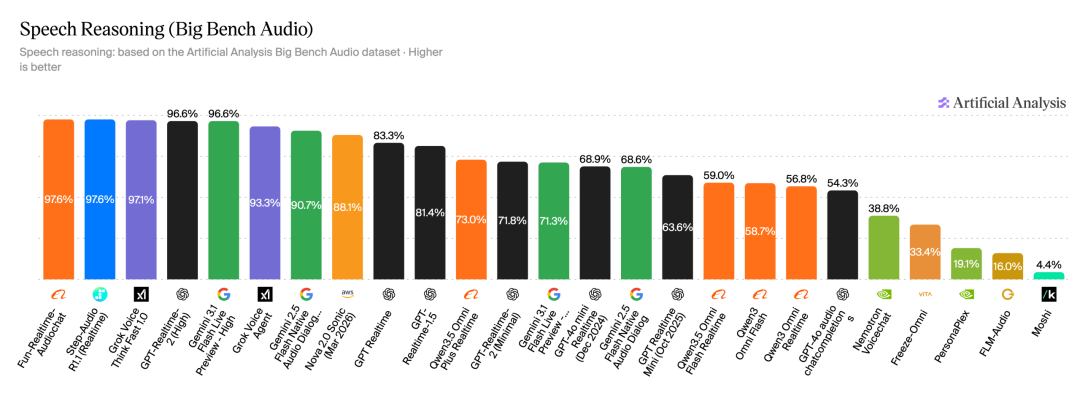
Qwen-Audio-3.0-Realtime:能聊天,还能办事!
又快又聪明,能聊天更能办事!阿里发布实时语音模型Qwen-Audio-3.0-Realtime,在毫秒级响应下实现深度推理与智能工具调用。 核心内容: 1. 模型在智商、工具调用、共情与交互流畅度四大主线同步升级 2. “压时延不掉智商”的技术突破与基准测试表现 3. 无需明确指令即可自行调用并记忆工具结果的智能Agent能力
百度开源 Unlimited OCR:一次读完一本书,大幅提升DeepSeek-OCR效果
百度开源Unlimited OCR,通过Reference Sliding Window Attention机制,将长文档OCR的KV缓存固定为常量,实现“一次读完一本书”的飞跃,大幅提升了DeepSeek-OCR在长文档处理上的效率和效果。 核心内容: 1. 长文档OCR面临的工程挑战与现有方案的局限性 2. Unlimited OCR的核心创新:Reference Sliding Window Attention机制 3. 新方法带来的性能提升与应用前景
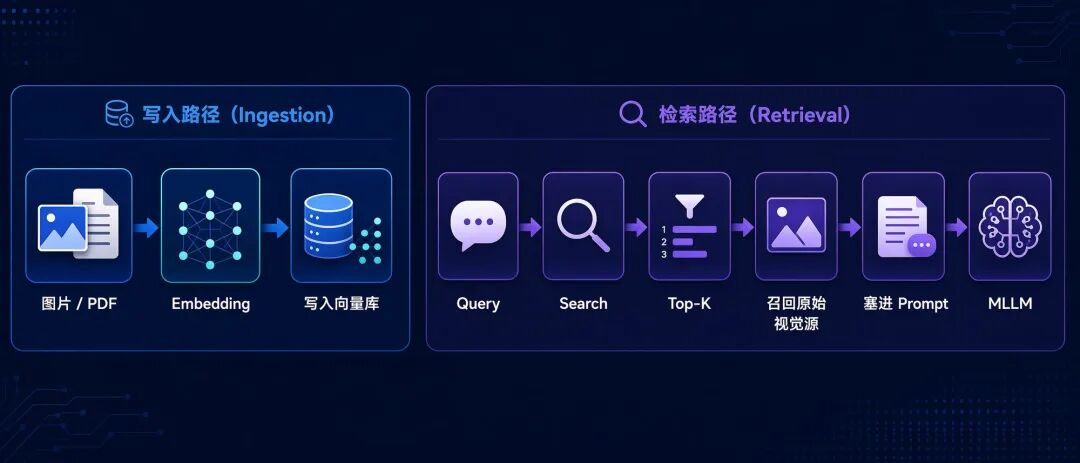
多模态 Agent 记忆,为什么不能当成升级版多模态RAG?
多模态Agent记忆并非简单升级版RAG,如何避免信息过载与token浪费?M3 Exam论文提出新思路。 核心内容: 1. 传统多模态记忆的常见问题与失败案例 2. M3 Proctor:将视觉内容转化为可检索文本代理 3. 显式决策机制与模态标签的应用价值
Om AI第二弹!VLX-Seek来了:3B小模型,细粒度感知反超Gemini
Om AI发布3B小模型VLX-Seek,在细粒度视觉感知任务上反超Gemini Pro,展现精准定位新突破。 核心内容: 1. VLX-Seek模型的核心能力:解决VLM“看懂却看不准”的难题 2. 技术突破:将物理实体转为region token,提升定位精度与推理效率 3. 性能表现:在多项基准测试中超越Gemini,适配端侧实时场景
小参数,大能力 | 星际视觉语言大模型再进化,0.8B轻量版正式发布
轻量级大模型如何实现端侧高效部署?极视角发布0.8B版星际视觉语言大模型,为产业终端带来低成本、高隐私的AI能力。 核心内容: 1. Stellaris-VL-0.8B模型的三大核心优势与产业级能力 2. 模型在架构轻量化、推理稳吞吐方面的关键优化 3. 终端广适配与本地高安全的落地价值
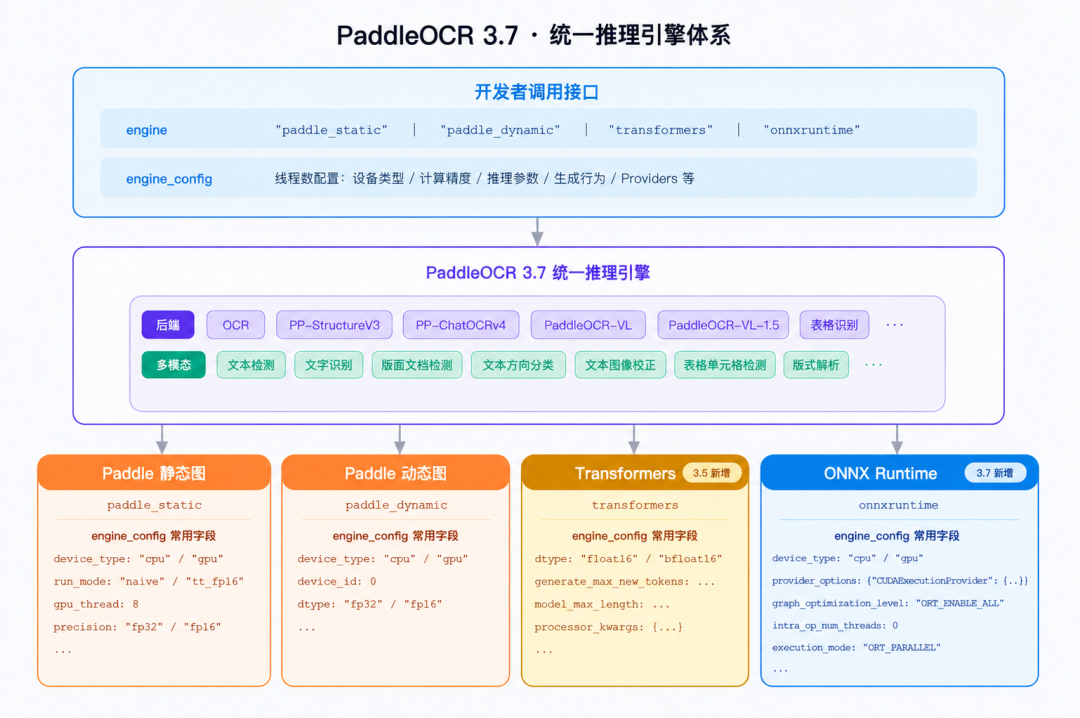
PaddleOCR 3.7 正式接入ONNX Runtime,一个参数换后端,轻量部署新选择
PaddleOCR 3.7.0 正式引入ONNX Runtime后端,仅需一个参数即可灵活切换推理引擎,为轻量级部署提供新选择。 核心内容: 1. 推理引擎抽象化与统一接口设计 2. ONNX Runtime后端的优势与特性 3. 多后端支持带来的灵活部署方案
正式推出 Gemma 4 12B: 一款统一、免编码器的多模态模型
无需编码器,Gemma 4 12B将先进多模态AI直接装进你的笔记本电脑,解锁本地智能体新体验。 核心内容: 1. 全新统一架构:免编码器设计,直接处理视觉与音频输入 2. 强大性能与轻量化:性能接近26B模型,仅需16GB内存即可本地运行 3. 开源生态与应用:Apache 2.0协议发布,已支持丰富开发者应用场景