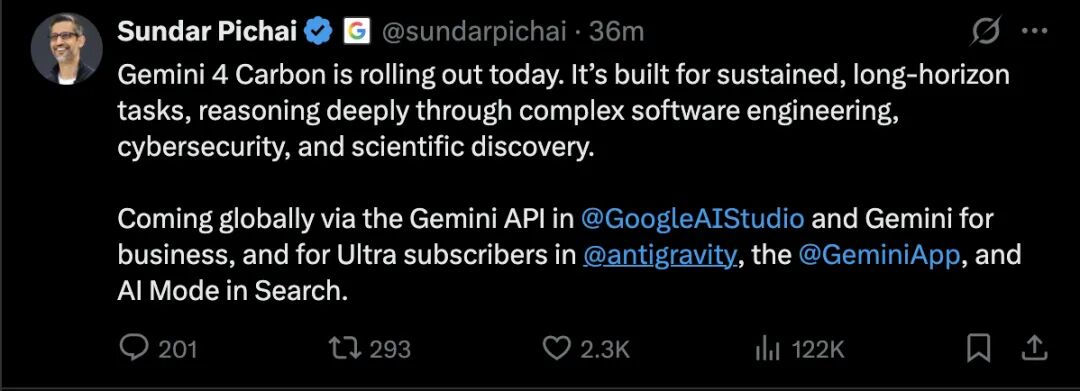
刚刚,谷歌 Gemini 4 Carbon 全面开放:一夜重写 OpenCode 桌面应用、多项复杂编程评测登顶
谷歌 Gemini 4 Carbon 正式向开发者、企业及科研人员全面开放,在 CursorBench 4.0、Perplexity WANDR 和 Zapier AutomationBench 三项 Agent 工作流评测中均排名第一,任务成本比次优外部模型低超 2 倍;同步推出 Antigravity /swarm 多 Agent 协同功能;在金融、科研、网络安全等高精度知识工作场景中展现长上下文、多模态与复杂推理能力;API 当前价格为 Claude Fable 5.2 的 1/4。
Agent 工作流评测全面领先,但能力呈现明显场景分化
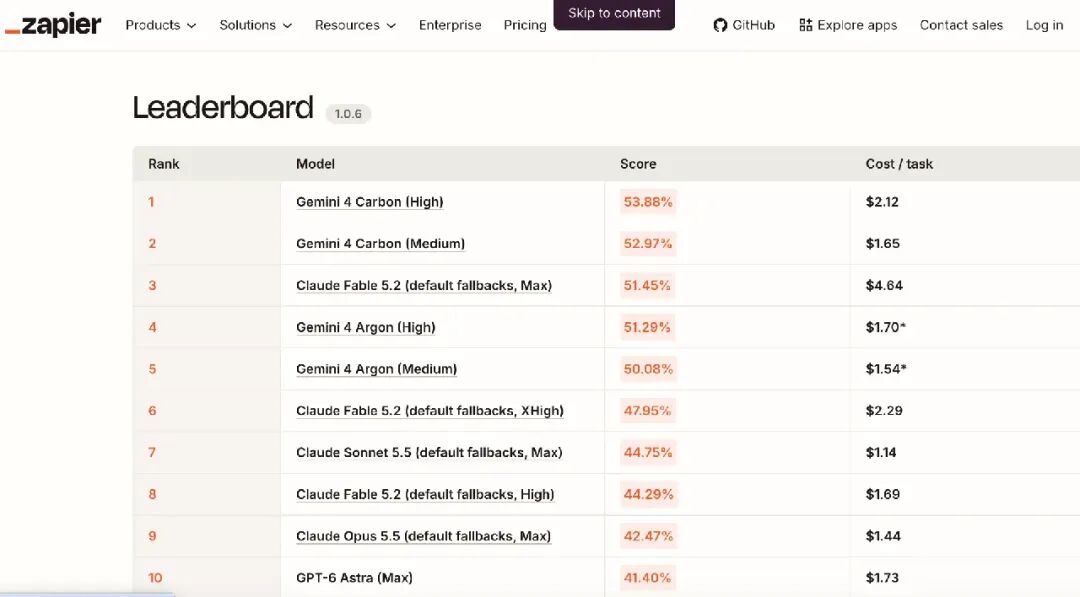
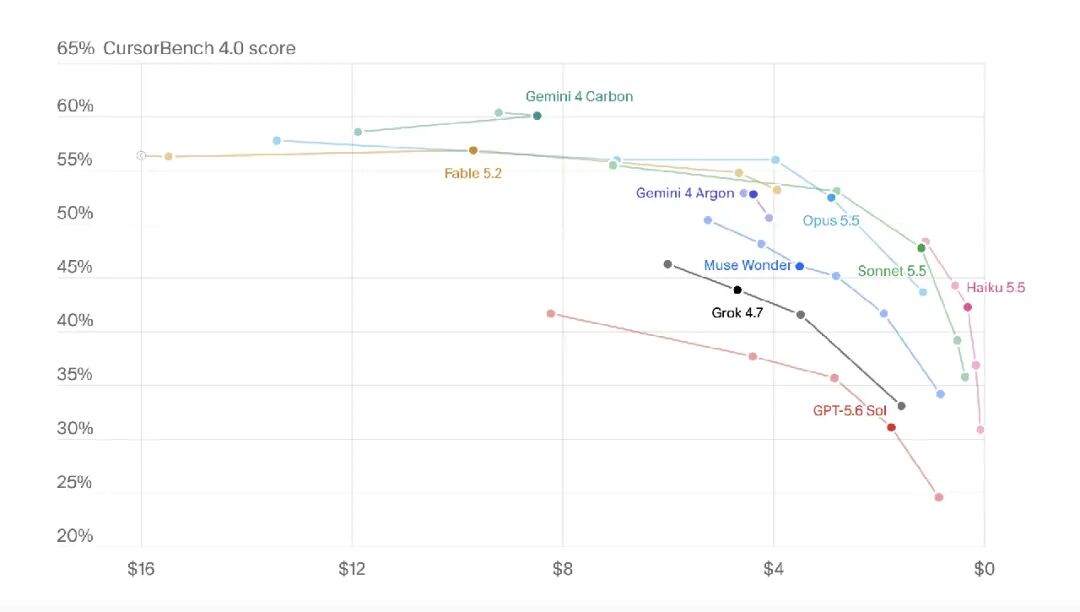
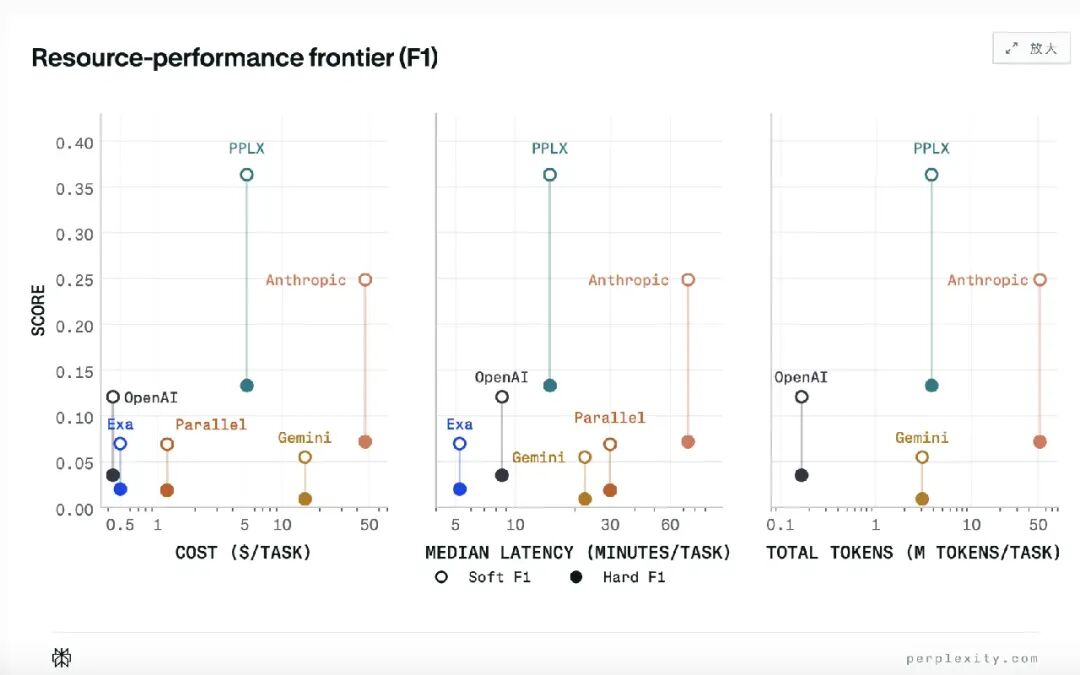
根据官方披露,Gemini 4 Carbon 在 CursorBench 4.0、Perplexity WANDR 和 Zapier AutomationBench 三项面向真实工作流程的评测中均排名第一,完成任务的成本比表现次优的外部模型低超过 2 倍。这三项评测分别涉及 AI 编程、信息检索与复杂任务执行,以及跨企业应用的业务流程自动化。
其中,Zapier AutomationBench 测试模型能否在真实业务工具和工作流中完成自动化任务。Google DeepMind 公布的成绩显示,Carbon 得分为 53.9%,超过 Gemini 4 Argon 的 51.3%、Claude Opus 5.5 的 42.5% 和 GPT-6 Astra 的 41.4%。
在更加偏向代码和系统操作的 Terminal-Bench 4.0 测试中,Carbon 取得 65.2% 的成绩,高于 Argon 的 57.1% 和 GPT-6 Astra 的 59.1%。
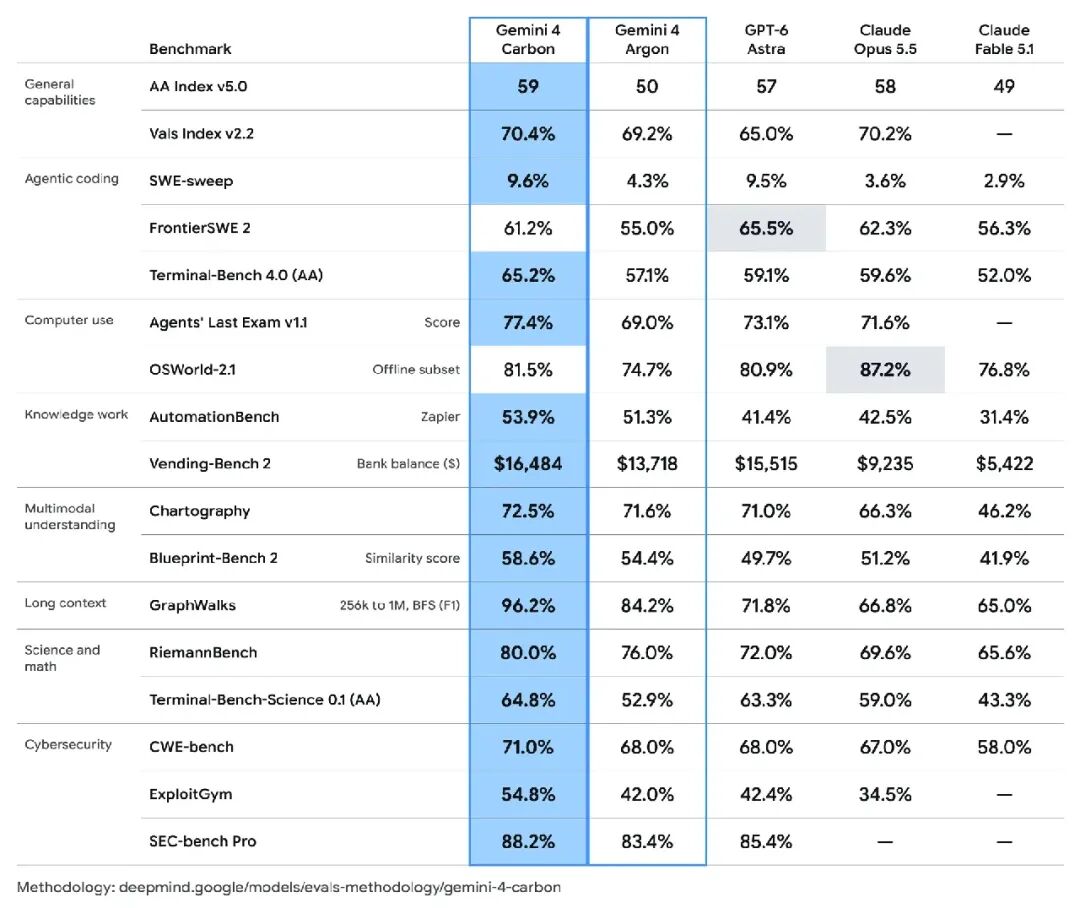
在面向长上下文推理的 GraphWalks 测试中,Carbon 的 F1 分数达到 96.2%,而 Argon 为 84.2%。这项测试的上下文范围为 256K 至 1M Token,主要考察模型在长距离信息关联与图结构搜索任务中的表现。
但值得注意的是,这些成绩并不意味着 Carbon 已经全面领先竞争对手。
Anthropic 于 11 月 9 日发布 Claude Fable 5.2 后,Artificial Analysis 的最新综合评测排名已经发生变化。在其发布版本对比中,Claude Fable 5.2 最高推理配置的 Intelligence Index 得分达到 65,而 Gemini 4 Carbon 的 high 配置得分为 60。
在 FrontierSWE v2 真实软件工程任务中,Claude Fable 5.2 取得 69.9%,Carbon 则为 61.2%。也就是说,不同模型在代码修改、终端任务、企业工作流和长程推理等场景中的表现已经出现明显分化。
所以 Carbon 在部分 Agent 任务中的优势,并不能说明其编程能力全面第一。
此外,Google 官方也明确指出,Gemini 4 Argon 仍然更适合大多数常规软件工程和知识工作任务,Carbon 则主要用于需要深入推理、复杂调试和长时间验证的高难度工作。
而 Google 此次强调的另一项指标是任务成本。按照官方说法,在上述三项工作流评测中,Carbon 的单任务成本比表现次优的外部模型低超过 2 倍。对于需要频繁调用模型、执行大量工具操作的企业而言,这一指标可能比单纯的基准测试得分更有现实意义。
Antigravity 推出 /swarm 功能,开启多 Agent 协同编程新范式
比评测成绩更值得关注的,是 Google 对 AI 编程工作方式的改变。
在此次发布中,Google 宣布为 Antigravity 预览推出 /swarm 功能。简单来说,开发者不再需要让一个 Agent 独立完成所有工作,而是可以通过一条提示词,调度多个 Agent 同时处理不同任务,并实时查看各自的执行进度。
这些 Agent 可以承担不同角色。
例如,让 Carbon 负责复杂的软件架构设计、任务协调及代码审查,再把相对简单的工作分配给速度更快、成本更低的模型。多个 Agent 可以在隔离的工作空间中并行执行任务,还可以引入专门负责对抗性验证的 Agent,对代码修改结果进行检查。
这样的设计,试图解决当前 AI 编程面临的一个现实问题:即使单个模型的编程能力越来越强,它仍然可能在长时间执行任务时偏离目标,或者在修改一个模块时破坏另一个模块。
通过任务分工、独立工作空间和相互验证,Google 希望将复杂项目从单个 Agent 的连续执行,转变为多个 Agent 的协同完成。
为了展示这一能力,Google 提供了多个实际案例。其中一个项目是重建埃菲尔铁塔的历史施工过程。
开发者只提供一条提示词,Carbon Agent 团队便利用 1887 年至 1889 年间的历史照片与工程图纸,制作出一个基于 Three.js 的交互式 3D 展览。
另一个案例更加复杂。
Google 使用 7 份公开的市议会规划 PDF,其中包含 206 个提取出的工程图视图,让 Agent 团队重建 Google Platform 37 办公区域。
在经历 10 轮夜间执行循环之后,系统生成了一个包含约 90.6 万个三角形网格的 Three.js 交互式 3D 模型。
这些案例并不能直接证明 Carbon 已经能够不经人工干预完成生产级软件开发,但至少展示了 Google 对下一代 AI 编程平台的构想。未来的开发者或许不再只是向模型逐条提出编程要求,而是像管理一个小型工程团队一样,分配目标、检查进度、验证成果。
不过,真正决定这种模式能否大规模应用的,仍然是 Agent 之间的协作成本、错误传播问题,以及复杂项目的最终交付质量。
进入高精度知识工作:金融、科研与多模态长流程任务
Google 这次还重点强调了 Carbon 在金融、法律和企业运营领域的应用。
与传统文本问答不同,这些工作通常需要模型同时处理大量表格、图表、图片、工程图纸和复杂文档,并根据特定格式输出结果。
例如,一项企业财务研究任务可能需要 Agent 阅读数十份财报、提取关键财务指标、核对不同年份的数据,再制作可以继续编辑的电子表格和分析报告。
其中任何一个环节出现错误,都可能影响最终结论。
Google 认为,现有基准测试还不能充分衡量模型在这种多模态、长流程知识工作中的表现。
因此,Google 与 Artificial Analysis 合作推出了新的 Multimodal Knowledge Agent(MKA)评测,用于测试模型在 Agent 工作流中处理复杂多模态文件的能力。
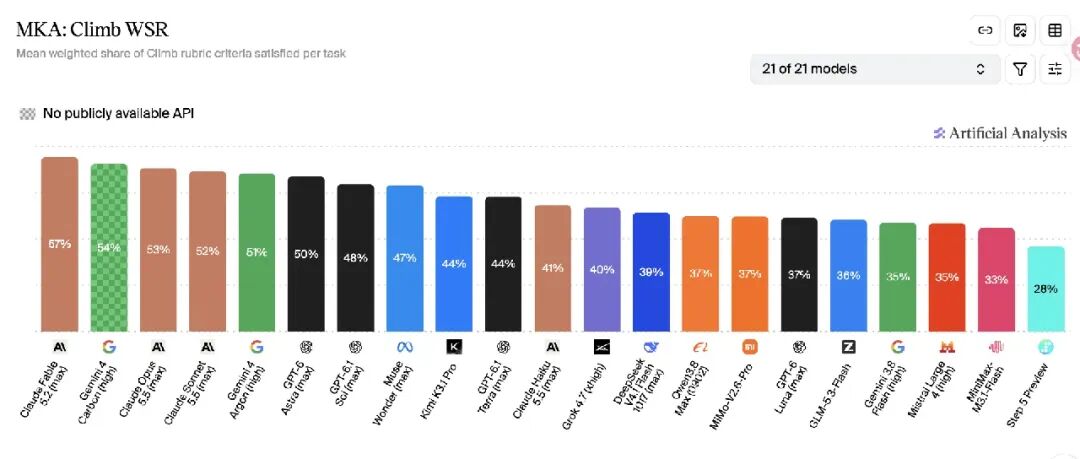
根据 Google 公布的结果,Carbon 在这项评测中排名第二,但其平均单任务成本比排名第一的模型低超过 6 倍。
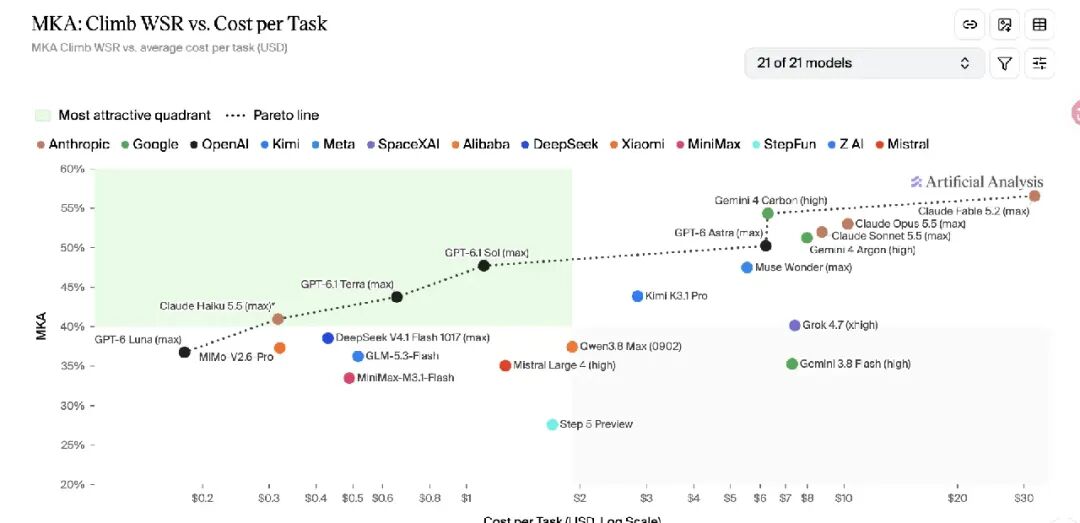
这一结果反映出另一种竞争路线:模型未必需要在所有指标中取得绝对最高分,但如果能够以明显更低的成本完成接近领先水平的任务,也可能具备商业价值。
在金融领域,Google 还披露了两项发布前评估结果。
Carbon 在 Hebbia 的 E2E Financial Agentic 评估中,与接受测试的最佳模型表现相当;在 Balyasny Asset Management 的 General Financial Intelligence 评估中,则位居 23 种前沿模型配置的前列。后者覆盖法律知识、工具调用、代码与数据工程,以及感知和上下文理解等多个维度。
如果说 AI 编程和企业自动化代表着大模型已经进入的商业市场,那么科学研究可能是 Carbon 此次展示中更值得长期关注的方向。
Google 公布,研究人员已经利用 Carbon 参与了多项科学研究工作,其中包括密码学代码形式化验证、实验室数据分析和蛋白质结构研究。
首先是密码学领域。
Google 研究人员构建了一个名为 AlphaProof Code 的 Agent 框架,用于对真实软件代码进行形式化验证。与普通代码测试不同,形式化验证的目标是通过数学方法证明程序满足特定性质,而不仅仅是检查它能否通过一组测试用例。
研究团队将这一方法用于 Signal 加密协议底层代码的安全性质证明。
Google 表示,研究人员使用 Carbon 和其他模型,将安全目标转化为数学定理,再由 AlphaProof Code Agent 利用 Carbon 生成数百万行 Lean 代码,协助完成形式化证明。按照 Google 的描述,研究团队在数周内完成了关键安全性质的证明工作,而类似任务过去可能需要专家团队投入数年。
但这项工作展示了大模型可能参与的一种更复杂的软件工程任务:不仅生成代码,还辅助建立关于代码正确性的数学证据。
在生命科学领域,Google 还披露了一项蛋白质研究结果。
AlphaFold 3 等蛋白质结构预测模型会利用多序列比对(MSA)寻找具有进化关系的蛋白质序列,从而获得结构预测所需的信息。
然而,一些研究较少的病毒、微生物和真核生物蛋白质,在现有数据库中难以找到足够多的同源序列,这会限制相关分析。
Google 研究人员采用多 Agent 系统,利用 Carbon 在 PB 级未注释序列档案、环境与病毒序列目录及三维结构数据库中,自主寻找远缘同源序列。
在 CASP17 盲测数据集中的 7 个低同源蛋白家族上,Carbon 使检索到的同源序列数量平均提高了 40 倍。
Google 表示,更大范围的评测仍在进行中。
此外,Carbon 还被用于实验室检测方法开发。研究人员向模型提供实验记录和原始数据,模型识别出自动化混合不充分等较难发现的实验异常,并协助分析色谱峰重叠及仪器样本残留问题。
这些应用展示了 AI 科研的一个新方向:模型不仅负责总结已有文献,还开始帮助研究人员检查实验数据、寻找异常、提出可验证的分析路径。
网络安全能力升级:漏洞召回率 100%,防护机制阻断 99% 攻击轨迹
网络安全仍然是 Carbon 最突出的技术方向之一。
10 月 28 日首次公布 Carbon 时,Google 就展示了它在漏洞发现、漏洞利用验证和漏洞修复三个环节中的表现。
在 SEC-bench Pro 漏洞发现评测中,Carbon 得分达到 88.2%;在 ExploitGym 漏洞利用能力测试中取得 54.8%;在 CWE-bench 漏洞修复测试中取得 71.0%。
11 月 10 日,Google 又公布了新的实际应用案例。
在 Google 自主安全系统 Project Fortify 的内部基准测试中,Carbon 在扫描环节实现了 100% 的召回率,漏洞分诊精确率达到 95%。在开源代码仓库测试中,Carbon 的召回率相较于 Argon 实现了超过 25% 的相对提升,并发现此前未被识别的真实逻辑漏洞。
Google Cloud Vulnerability Research 团队还利用 Carbon 验证了某款流行开源软件中的两个缺陷确实可以被利用,并构建了概念验证代码,帮助维护者将其重新认定为严重漏洞并及时发布补丁。
出于负责任的漏洞披露要求,Google 暂未公开具体漏洞细节。
在 Wiz 的 Scan for Good 项目中,Carbon 还被用于检查公共数字基础设施。
Google 表示,在针对两家大型 SaaS 服务提供商的扫描中,Carbon 在不到两个小时内发现了零日漏洞,随后相关团队与受影响企业合作开展修复。
如果这些实际应用能够在更大范围内得到验证,AI 可能改变安全研究中最耗时的部分工作:从大量代码中寻找潜在缺陷,验证它们能否被利用,并提出可运行的修复方案。
但问题也随之而来。
模型越擅长发现和验证漏洞,其能力就越有可能被恶意使用。
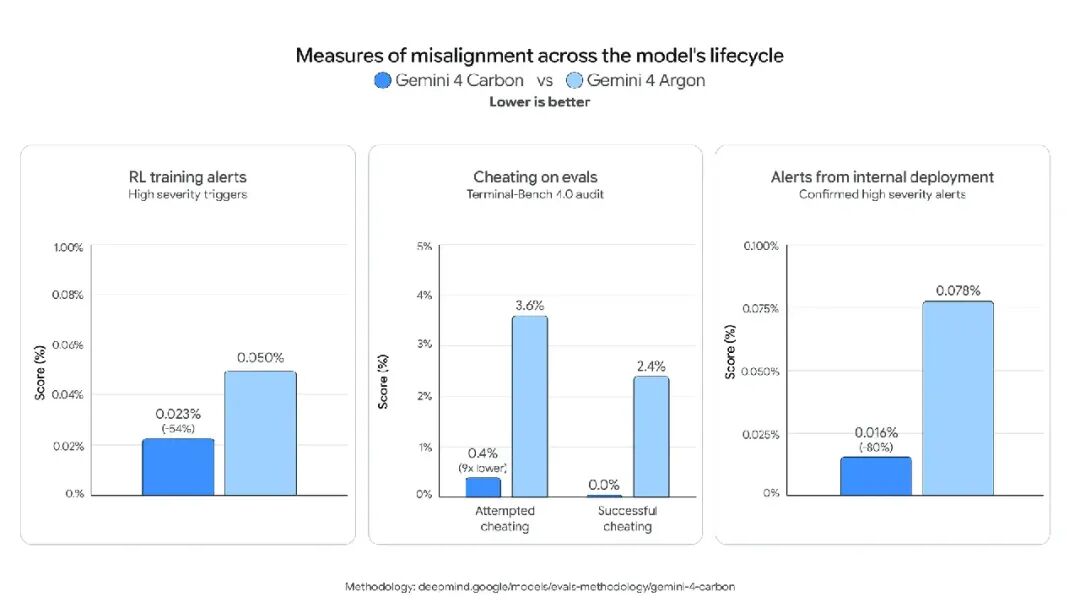
因此,Google 此次也公布了新的安全防护评估。在包含 ExploitBench 和 CyScenarioBench 的模拟网络攻击环境中,Google 表示,Carbon 的安全机制阻断了自适应红队 Agent 发起的 99% 攻击轨迹。
其单次尝试突破防护的比例从 Argon 的 3.1% 降至 0.8%。
在 Gray Swan 的自动化网络攻击测试中,攻击查询成功率从 Argon 的 9.86% 降至 Carbon 的 2.17%。
外部机构 Trajectory Labs 则在 132 小时、超过 1.3 万次请求的测试中,没有发现新的通用越狱方法。
Google 还披露,在其包含 375 项任务的 Agent 诚实性测试中,Carbon 的通过率达到 92%,高于 Argon 的 70%。
而针对能力更强的网络安全版本,Google 仍然采用 Fairwind Program 的受控开放方式,并未将相关能力全部直接提供给普通用户。
价格降至 Claude Fable 5.2 的 1/4,优惠期至 2026 年 11 月 30 日
在模型能力之外,价格是此次发布的另一个重要看点。
Google 宣布,Gemini 4 Carbon 在公开 API 中采用与 Argon 相同的限时优惠价格:每百万输入 Token 2 美元,每百万输出 Token 10 美元。
相比 Claude Fable 5.2 每百万输入 Token 8 美元、输出 Token 40 美元的标准价格,Carbon 当前的单位 Token 价格为其四分之一。
不过,这一价格优势有明确期限。
Google 官方注明,优惠期将于 2026 年 11 月 30 日结束。此后,Carbon 的公开 API 标准价格将调整为每百万输入 Token 4 美元、输出 Token 20 美元。
届时,其单位 Token 价格将是当前优惠价格的两倍。
另一方面,单位 Token 价格低,并不代表完成同一项任务的实际成本一定更低。Google 自己也承认,Carbon 在复杂任务中会使用比 Argon 更多的 Token,以进行深入探索、推理和多轮验证。
Google DeepMind 高级副总裁、Google 首席 AI 架构师 Koray Kavukcuoglu 也 x 上发文,为 Gemini 4 Carbon 的全面开放造势。
他透露,Google 内部已经大量使用 Carbon 处理最复杂的长程任务,包括协助研究团队通过数学方法验证 Signal 核心加密协议的安全性质。此外,Carbon 在 CursorBench 4.0、Perplexity WANDR 和 Zapier AutomationBench 等独立基准测试中也名列前茅。
他还分享了一个颇具看点的案例:Google 团队利用 Carbon 分析阿波罗登月舱的历史照片和技术图纸,尝试重建这款人类首次载人登月使用的航天器。 由于阿波罗登月舱并没有完整返回地球的实物可供研究,团队主要依靠留存的历史影像和工程资料,让 Carbon 重建出可视化的 3D 模型,并进一步制作成演示视频。
实测反馈:OpenCode 一夜重写桌面应用,3D 物理仿真与多模态生成能力突出
除了基准测试成绩,Gemini 4 Carbon 在实际软件开发中的表现也获得了开发者的认可。尤其是在需要长时间自主执行的复杂编程任务中,Carbon 已经开始承担从技术方案设计到代码实现的完整工作流程。
“当时,我们一直无法让应用程序的界面与现有 UI 框架保持一致。于是,在一天工作结束前,我们向 Carbon 提交了一份需求清单。结果,一夜之间,Carbon 就从零开始构建了一个全新的 Rust UI 库,还重写了我们的 OpenCode 桌面应用,并提供了能够正常运行的演示程序。这是一个思考能力极其出色的模型。如今,在处理最棘手的任务时,Carbon 已经成为我们首选的规划模型。”
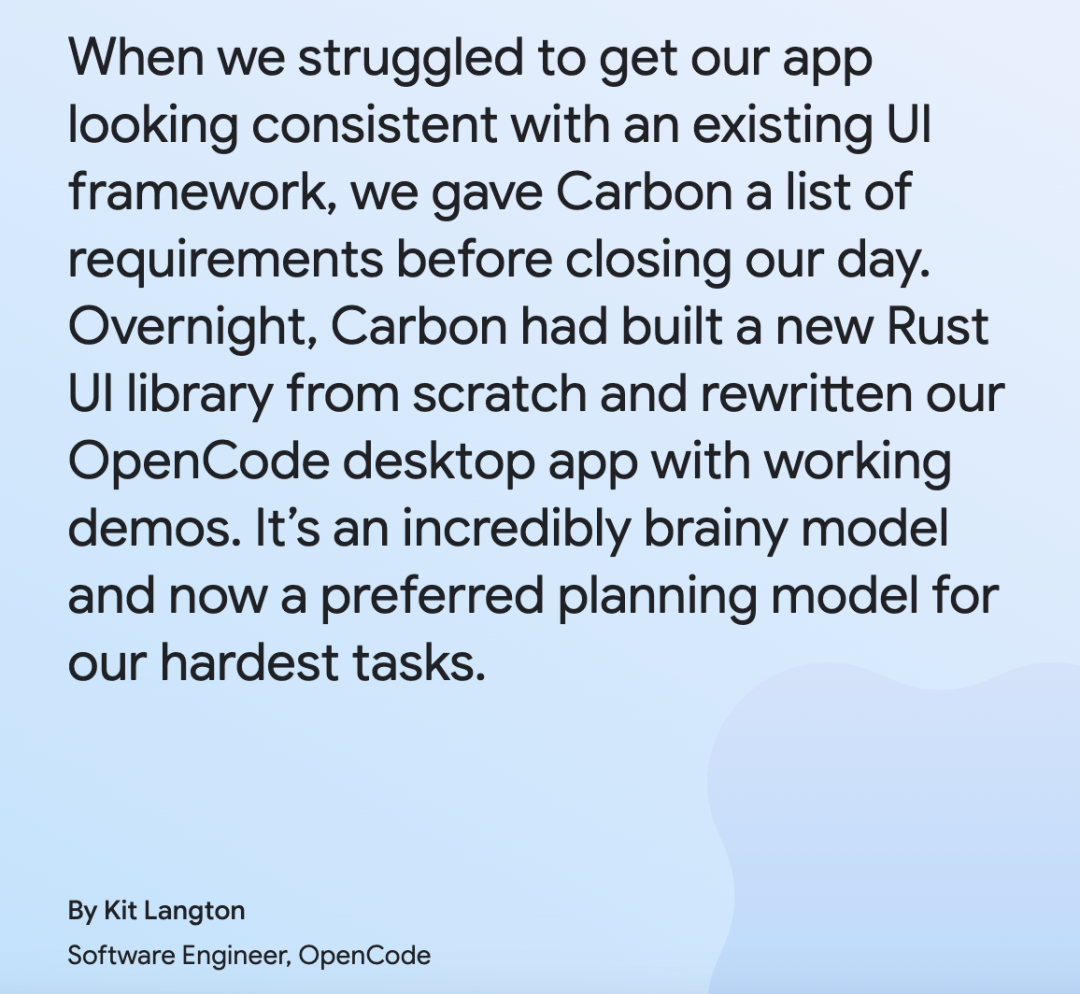
随着 Gemini 4 Carbon 正式开放,首批获得提前体验资格的开发者也开始陆续分享自己的测试结果。相比官方公布的基准测试成绩,这些来自真实使用场景的反馈,或许更能反映 Carbon 在实际任务中的表现。
在 x 上,一位提前体验 Carbon 的开发者对新模型给出了积极评价。
他表示:“我有幸提前体验了 Gemini 4 Carbon,它是一个非常优秀的模型,相比 Argon 有所改进。”
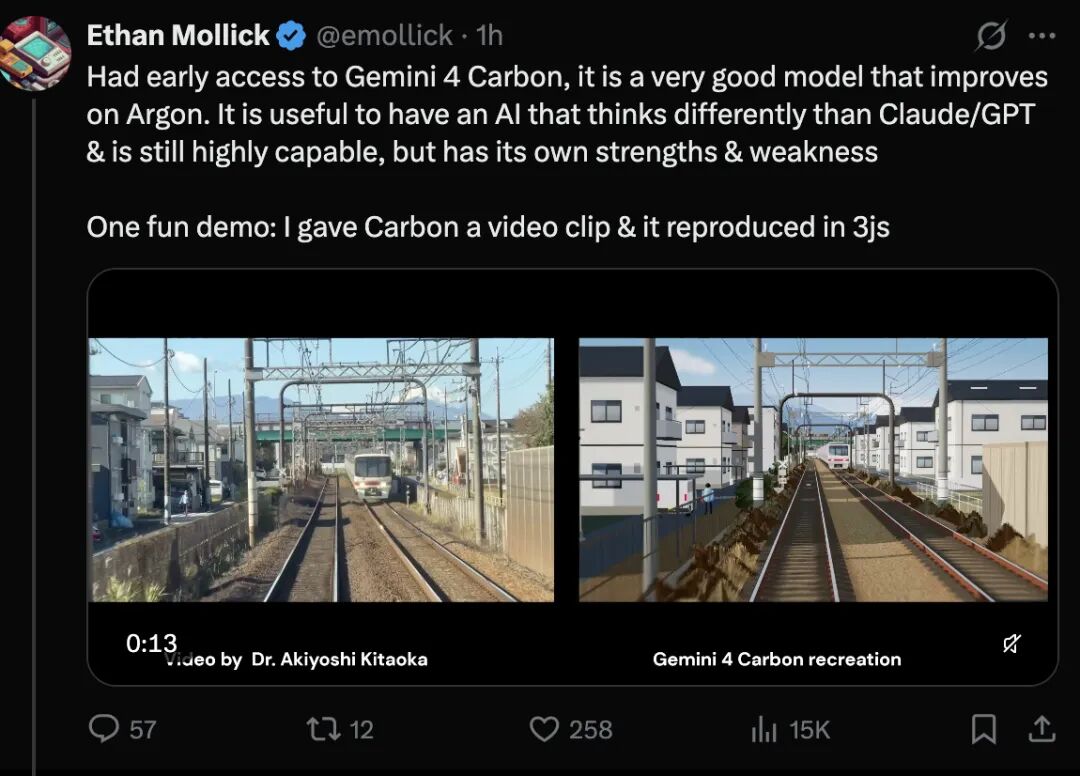
不过,在他看来,Carbon 的价值并不只是性能提升,还在于它提供了不同于 Claude 和 GPT 的问题解决思路。
“拥有一个思维方式与 Claude/GPT 不同的 AI 非常有用。它同样功能强大,但也有自己的优势和劣势。”
该开发者还展示了一个颇有意思的测试案例:他向 Carbon 提供了一段视频,要求模型使用 Three.js 复现视频中的画面和效果。最终,Carbon 成功生成了相应的 Three.js 实现。
这一案例展示了 Carbon 将视觉信息转化为可运行代码的能力。相比单纯理解视频内容,模型还需要识别画面中的视觉元素及其变化,并将其转化为三维场景和程序逻辑。
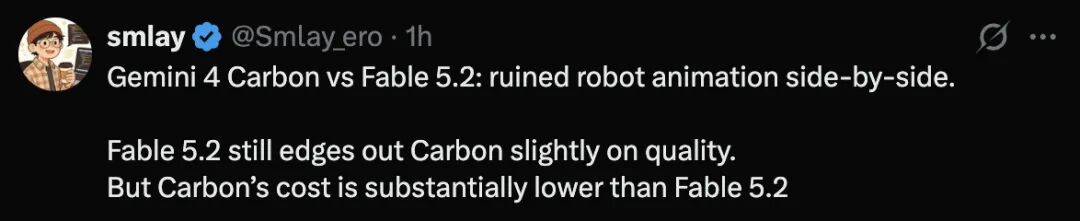
还有开发者使用 Gemini 4 Carbon 和 Claude Fable 5.2 分别生成“废墟机器人”动画,并对比两款模型的生成效果。测试者认为,在质量方面 Fable 5.2 仍然略胜 Carbon 一筹。但 Carbon 的成本远低于 Fable 5.2。
在另一项 3D 动画生成测试中,有开发者利用 Gemini 4 Carbon 从零编写了一套自定义 CUDA/C++ 路径追踪器,并集成 MuJoCo 刚体物理引擎,设计出一套长达 60 秒的鲁布·戈德堡机械装置(即通过一系列连锁反应完成任务的复杂机械系统)。
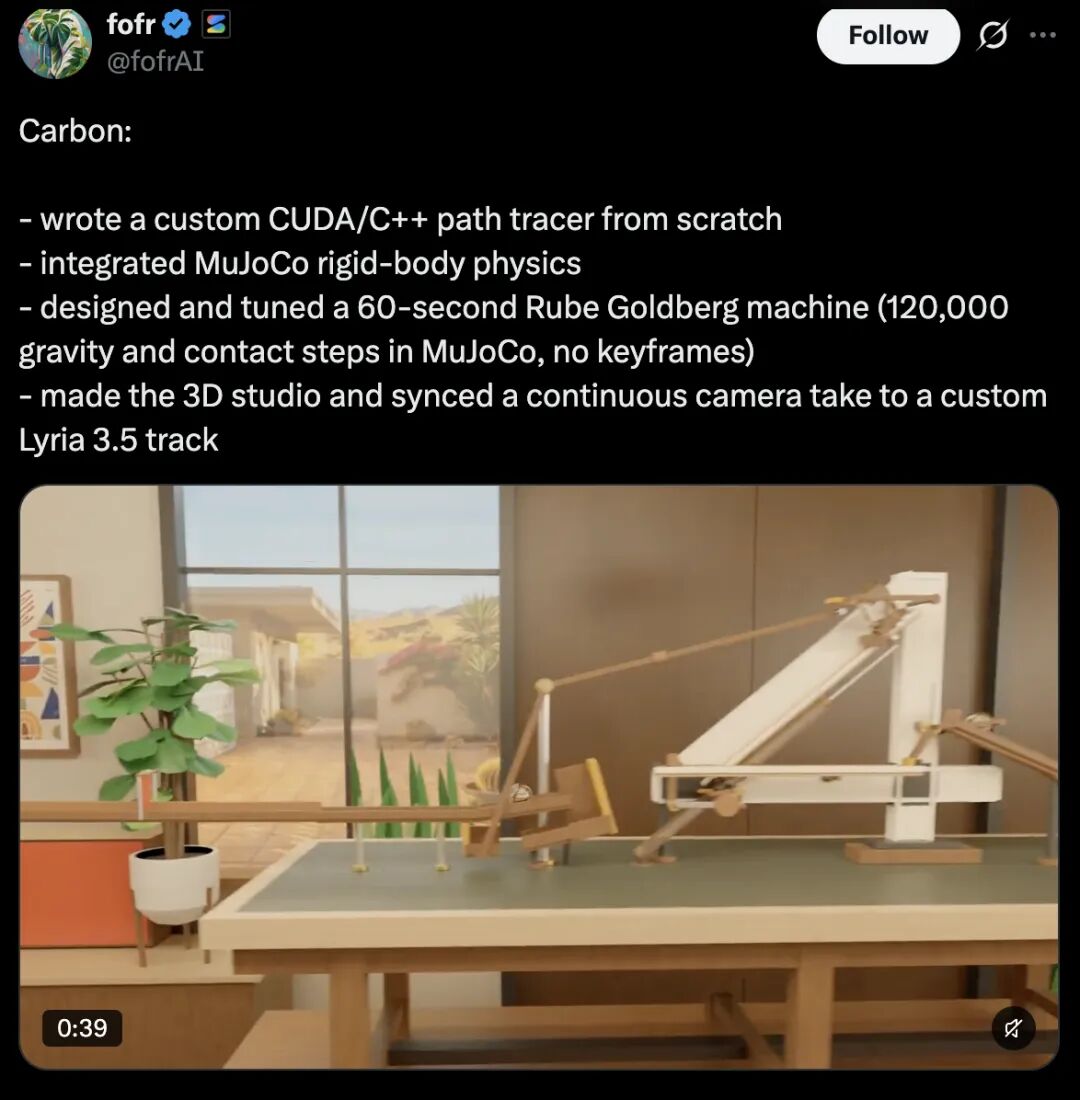
整个动画在 MuJoCo 中模拟了 12 万个重力与物体接触计算步骤,未使用关键帧动画。此外,Carbon 还完成了 3D 工作室场景搭建,并将连续运镜与定制的 Lyria 3.5 音乐轨道同步。最终,开发者展示了一段融合物理模拟、3D 渲染、连续镜头和音乐的完整动画,体现了 Carbon 在复杂编程、物理仿真与多媒体内容制作方面的综合能力。
另一位开发者则展示了 Gemini 4 Carbon 在 3D 建模和物理模拟方面的能力。仅凭一张参考图片,Carbon 就构建出一座以 19 世纪巴黎为灵感的交互式物理实验室,名为 Analyse Spectrale(Mod. M1-2-15)。 整个场景包含 92 个由黄铜、铜和硼硅酸盐玻璃构成的精密部件,还实现了实时 Beer-Lambert 光吸收与 Rankine 涡旋效果、轴向爆炸视图,以及复古档案风格的 Bento 用户界面。其中,界面还包含以 60 FPS 运行的 SVG 瓦特指示器和工程示意图。
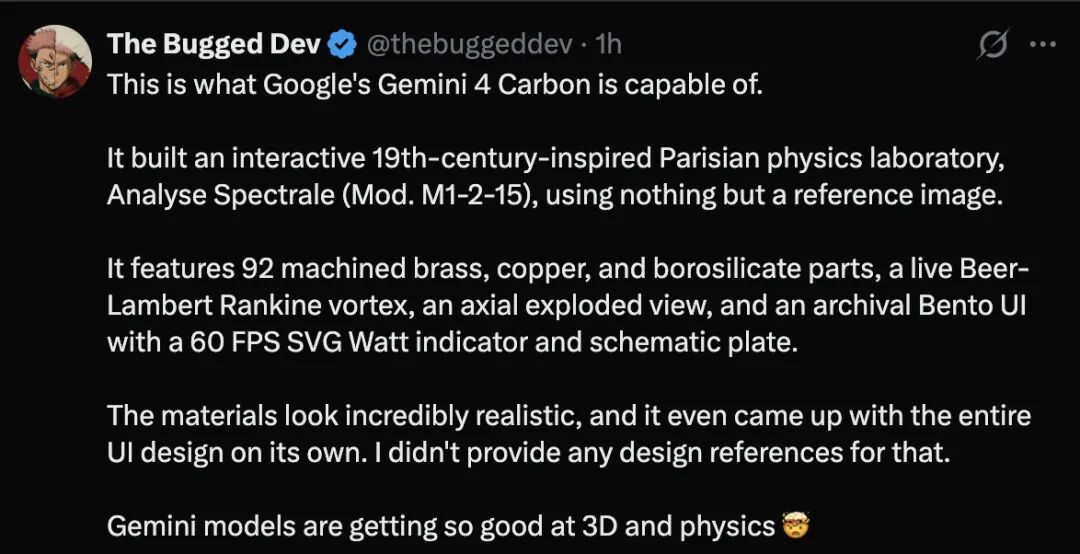
令开发者惊讶的是,Carbon 不仅高度还原了不同材料的真实质感,还自主设计了整套 UI,而他并未提供任何界面设计参考。 他感叹道:“Gemini 模型在 3D 和物理模拟方面真的越来越强了,简直令人震惊!”
JOTO 企业落地观察
- 企业若计划将 Carbon 引入智能体工程,需重点评估其在多 Agent 协同中的角色切分机制——Carbon 明确定位为高难度任务协调者,而非通用执行单元,这意味着团队需重构 Agent 架构设计,避免将其误用为“全能型主力”,否则将放大 Token 消耗与响应延迟风险。
- Carbon 在 MKA 评测中以显著更低成本达成次优效果,这对 RAG 知识工程具有启示:当企业知识库更新频次高、查询并发量大时,可优先采用 Carbon 作为轻量级路由与摘要层,将高精度解析任务按需委派给专用模型,形成成本可控的混合推理链。
- Carbon 的价格策略设定了明确的窗口期(至 2026 年底),这对企业 AI 安全治理构成时间压力:需在优惠期内完成模型选型、POC 验证、成本建模与灰度上线,否则将面临单位成本翻倍与架构迁移的双重挑战。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们